호적 인명 이름자 — 제공 그림

원고 Ⅳ장의 그림 1–3(요청하신 그림)과, 원고 Ⅳ장의 물음을 자료로 살펴본 추가 그림 12장입니다. 모든 그림은 받은 동일인 매칭 자료(기초통계 PDF 와 같은 판)에 원고 Ⅳ장의 기준(남성 본인 이름값 · 사조 제외 · 계층 3분 · 25년 추정 코호트 · 1676–1850)을 적용해 그렸습니다. 모든 그림을 한국어·English 두 언어와 여섯 비율로 찍어 두었습니다 — 아래에서 고르면 모든 그림의 미리보기와 「PNG 받기」가 그 판으로 바뀝니다(긴 변 3200 픽셀). 다른 조건이 필요하면 각 그림의 인터랙션 페이지에서 바꿔 찍을 수 있습니다(머리줄의 「비율」·「캡처 보기」).

언어비율
모두 받기

1. 요청하신 그림

세 그림은 받은 최신 자료로 그렸습니다. 원고 Ⅳ장의 표는 그보다 앞선 판의 자료로 계산된 것으로 보여 일부 값이 다릅니다 — 각 그림 아래 「원고 표와 최신 값」에서 견줄 수 있습니다(본문 표를 최신 값으로 바꾸면 그림과 맞습니다). 계층 3분은 이름값이 처음 적힌 행의 대분류·계층4분류로 정했습니다 — 최상·상층 = 대분류 Y 이고 계층 최상·상, 중층 = Y 이고 중, 하층 = C 또는 U. 원고가 계층을 행 단위로 정했는지 인물 단위로 정했는지 알려 주시면 맞추겠습니다.
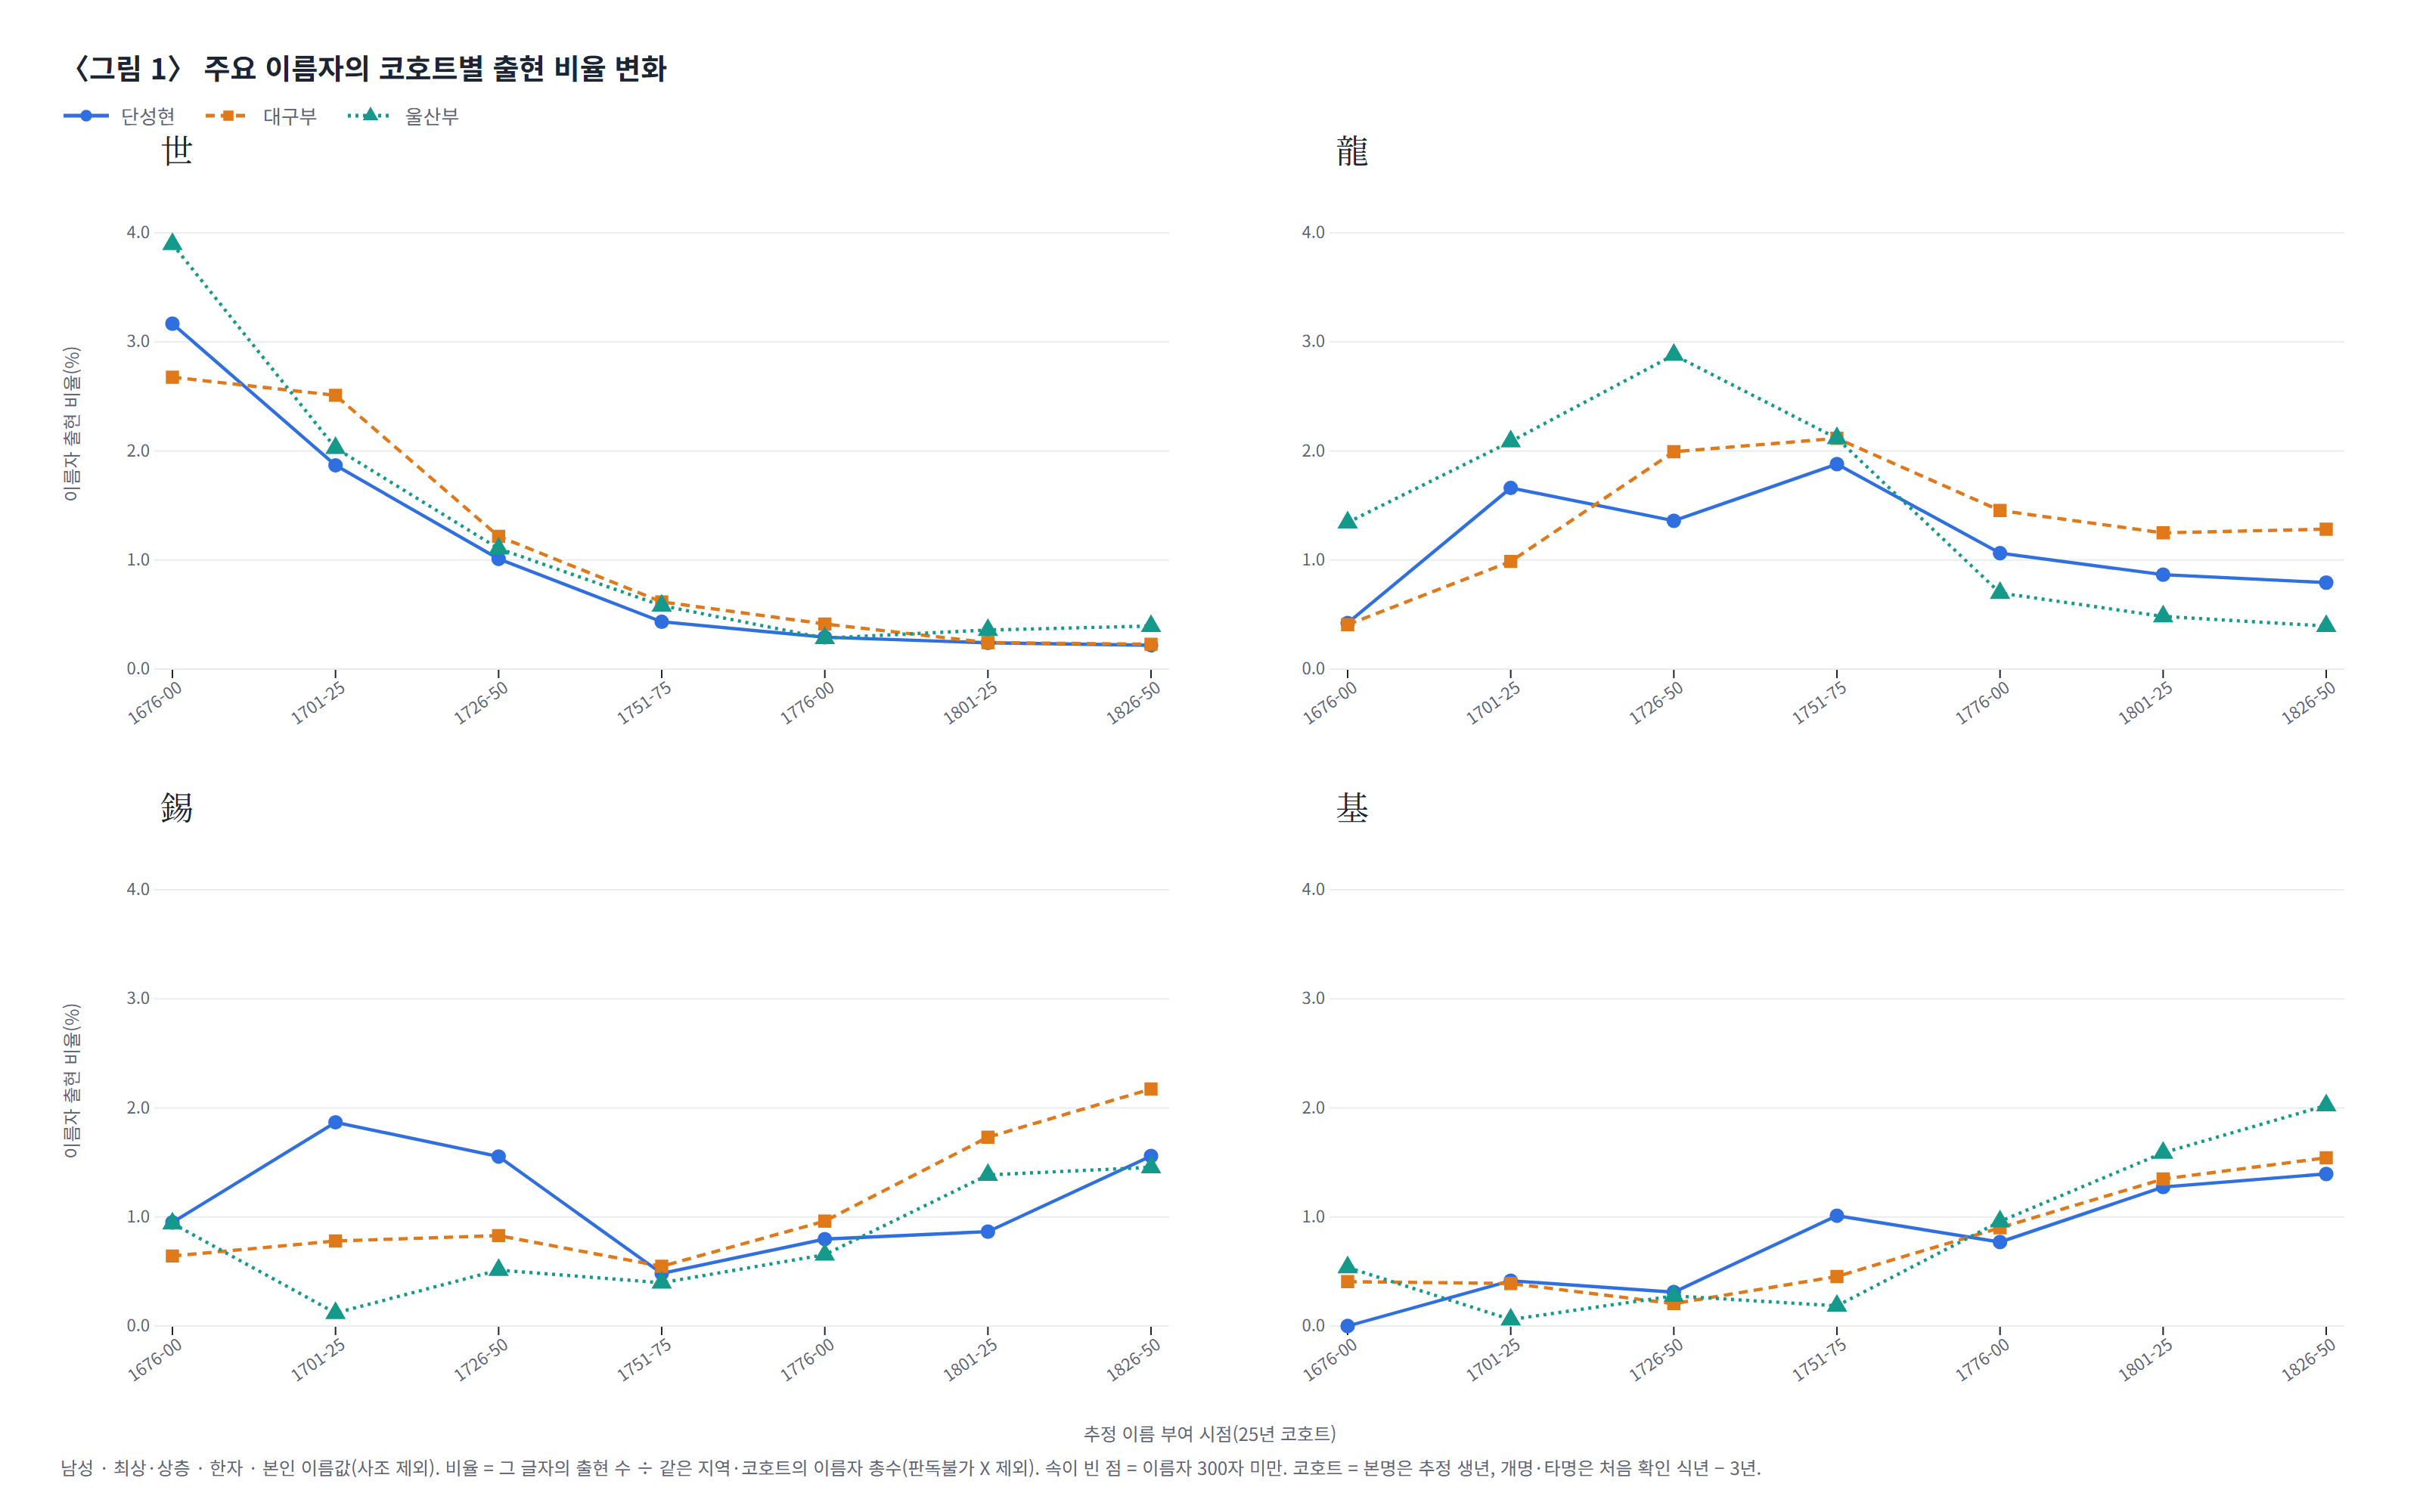
〈그림 1〉 주요 이름자의 코호트별 출현 비율 변화

〈그림 1〉 주요 이름자의 코호트별 출현 비율 변화

요청 「世·龍·錫·基 등 대표 한자 3~4개를 선택하여 세 지역의 변화 양상을 비교. 제Ⅳ장 2절의 통시적 논증을 뒷받침하는 그림.」

무엇을 셌나 남성 · 최상·상층 · 한자 · 본인 이름값(사조 제외). 비율 = 그 글자의 출현 수 ÷ 같은 지역·코호트의 이름자 총수(판독불가 X 제외). 글자마다 칸 하나, 칸 안에 세 지역 선, 모든 칸이 같은 눈금. 속이 빈 점 = 이름자 300자 미만.

원고 표와 최신 값 (표 8)
표 8 — 코호트별 세 지역 최상·상층 남성의 최빈 이름자

|---|---|---|---|

코호트지역원고최신
1676-1700단성현世 3.2%世 3.2%
1676-1700대구부世 2.9%世 2.7%
1676-1700울산부世 3.7%世 3.9%
1701-1725단성현德 2.2%命 2.2%
1701-1725대구부世 2.4%世 2.5%
1701-1725울산부鳳 2.4%鳳 2.3%
1726-1750단성현德 2.0%啓 2.1%
1726-1750대구부龍 2.2%命·龍 2.0%
1726-1750울산부龍 3.1%龍 2.9%
1751-1775단성현龍 2.3%思·漢 1.9%
1751-1775대구부龍 2.2%龍 2.1%
1751-1775울산부德 2.5%德 2.4%
1776-1800단성현正·漢 각 2.0%漢 2.0%
1776-1800대구부宗 1.9%光 1.8%
1776-1800울산부德 1.8%德 1.9%
1801-1825단성현成 2.5%成 2.2%
1801-1825대구부錫 1.8%錫 1.7%
1801-1825울산부基 1.7%宗 1.7%
1826-1850단성현成 2.4%成 2.5%
1826-1850대구부錫 2.2%錫 2.2%
1826-1850울산부基 2.0%基 2.0%
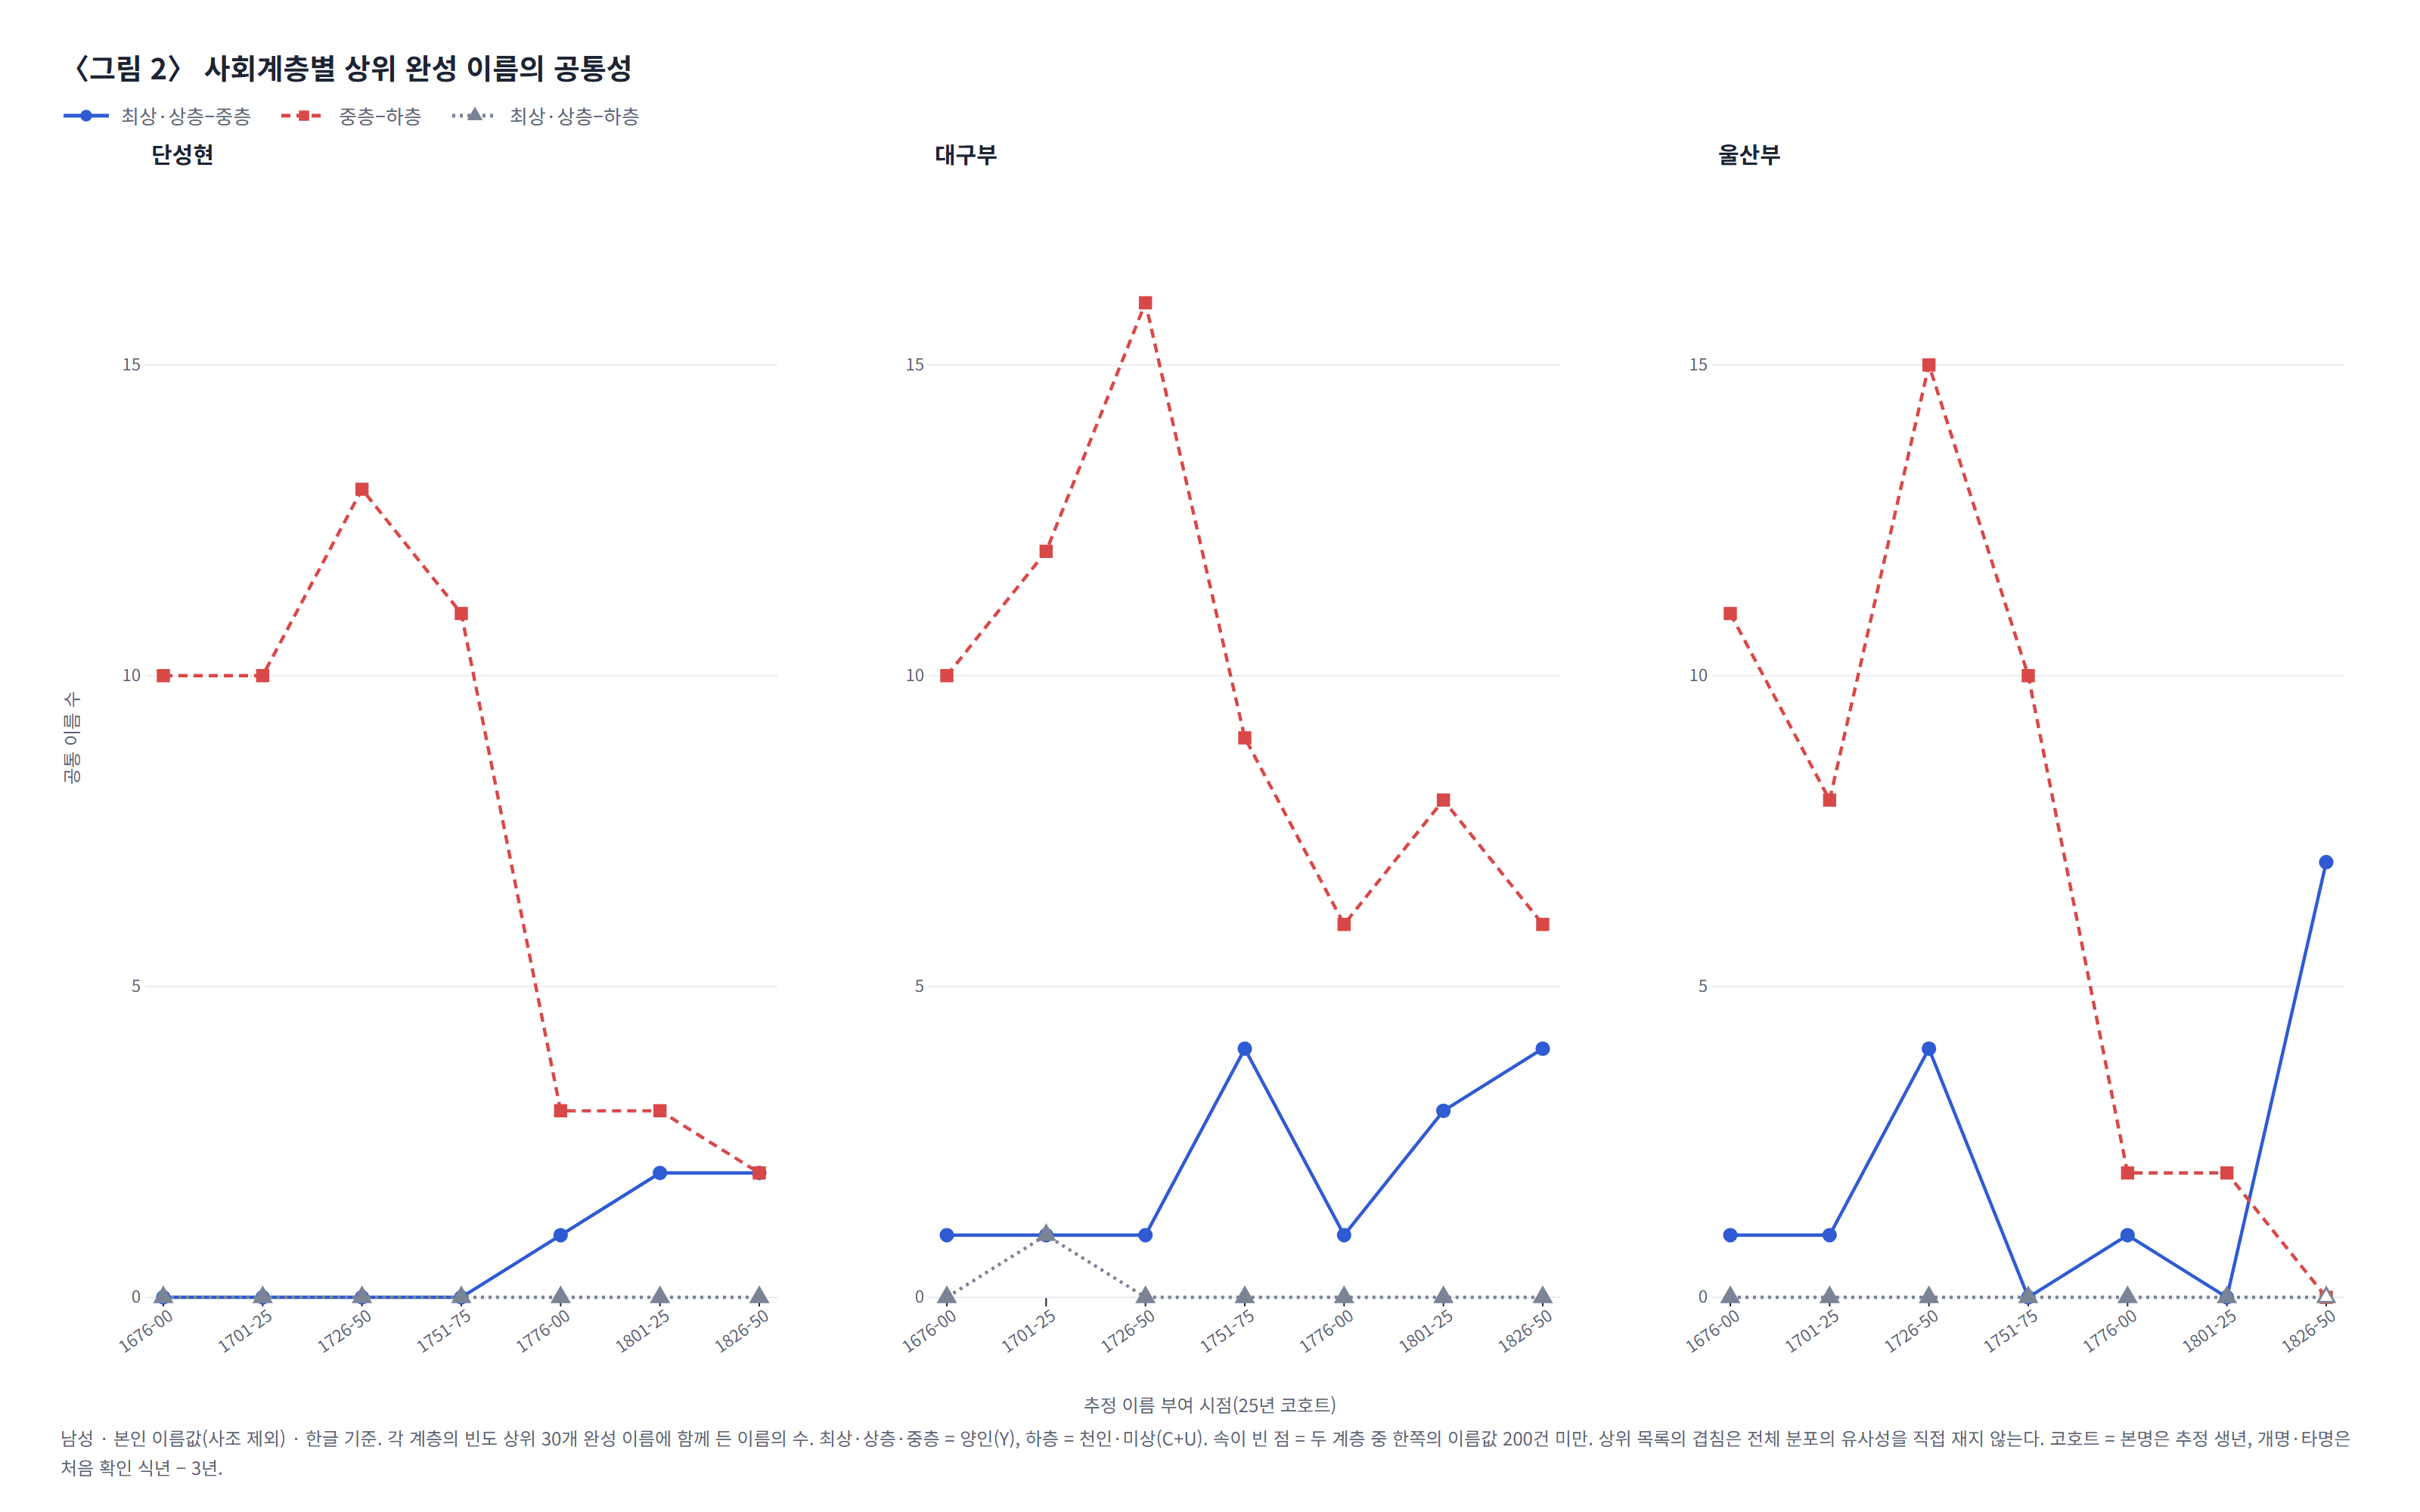
〈그림 2〉 사회계층별 상위 완성 이름의 공통성

〈그림 2〉 사회계층별 상위 완성 이름의 공통성

요청 「최상·상층–중층, 중층–하층, 최상·상층–하층의 상위 이름 교집합을 코호트별로 비교. 이번 논문의 핵심적인 발견을 보여 주는 그림.」

무엇을 셌나 남성 · 본인 이름값(사조 제외) · 한글 독음. 계층마다 빈도 상위 30개 완성 이름에 함께 든 이름의 수(원고 표 10 과 같은 기준). 지역마다 칸 하나, 계층 쌍마다 선 하나. 속이 빈 점 = 두 계층 중 한쪽의 이름값 200건 미만(울산부 1826–1850 하층).

원고 표와 최신 값 (표 10)
표 10 — 코호트별·계층별 상위 30개 완성 이름의 공통 항목 수(한글 독음)

|---|---|---|---|---|

코호트지역원고 상–중 · 중–하 · 상–하최신 상–중 · 중–하 · 상–하최신 이름값 수(상·중·하)
1676-1700단성현1 · 10 · 00 · 10 · 0516 · 2,845 · 3,178
1676-1700대구부2 · 11 · 01 · 10 · 02,327 · 19,983 · 13,296
1676-1700울산부1 · 14 · 01 · 11 · 0387 · 7,827 · 2,884
1726-1750단성현1 · 13 · 00 · 13 · 01,301 · 6,232 · 3,459
1726-1750대구부2 · 15 · 01 · 16 · 06,039 · 29,658 · 13,815
1726-1750울산부4 · 13 · 14 · 15 · 01,263 · 11,466 · 2,299
1826-1850단성현3 · 2 · 02 · 2 · 01,739 · 2,464 · 793
1826-1850대구부4 · 7 · 04 · 6 · 08,786 · 19,964 · 3,407
1826-1850울산부6 · 1 · 07 · 0 · 01,999 · 2,282 · 102
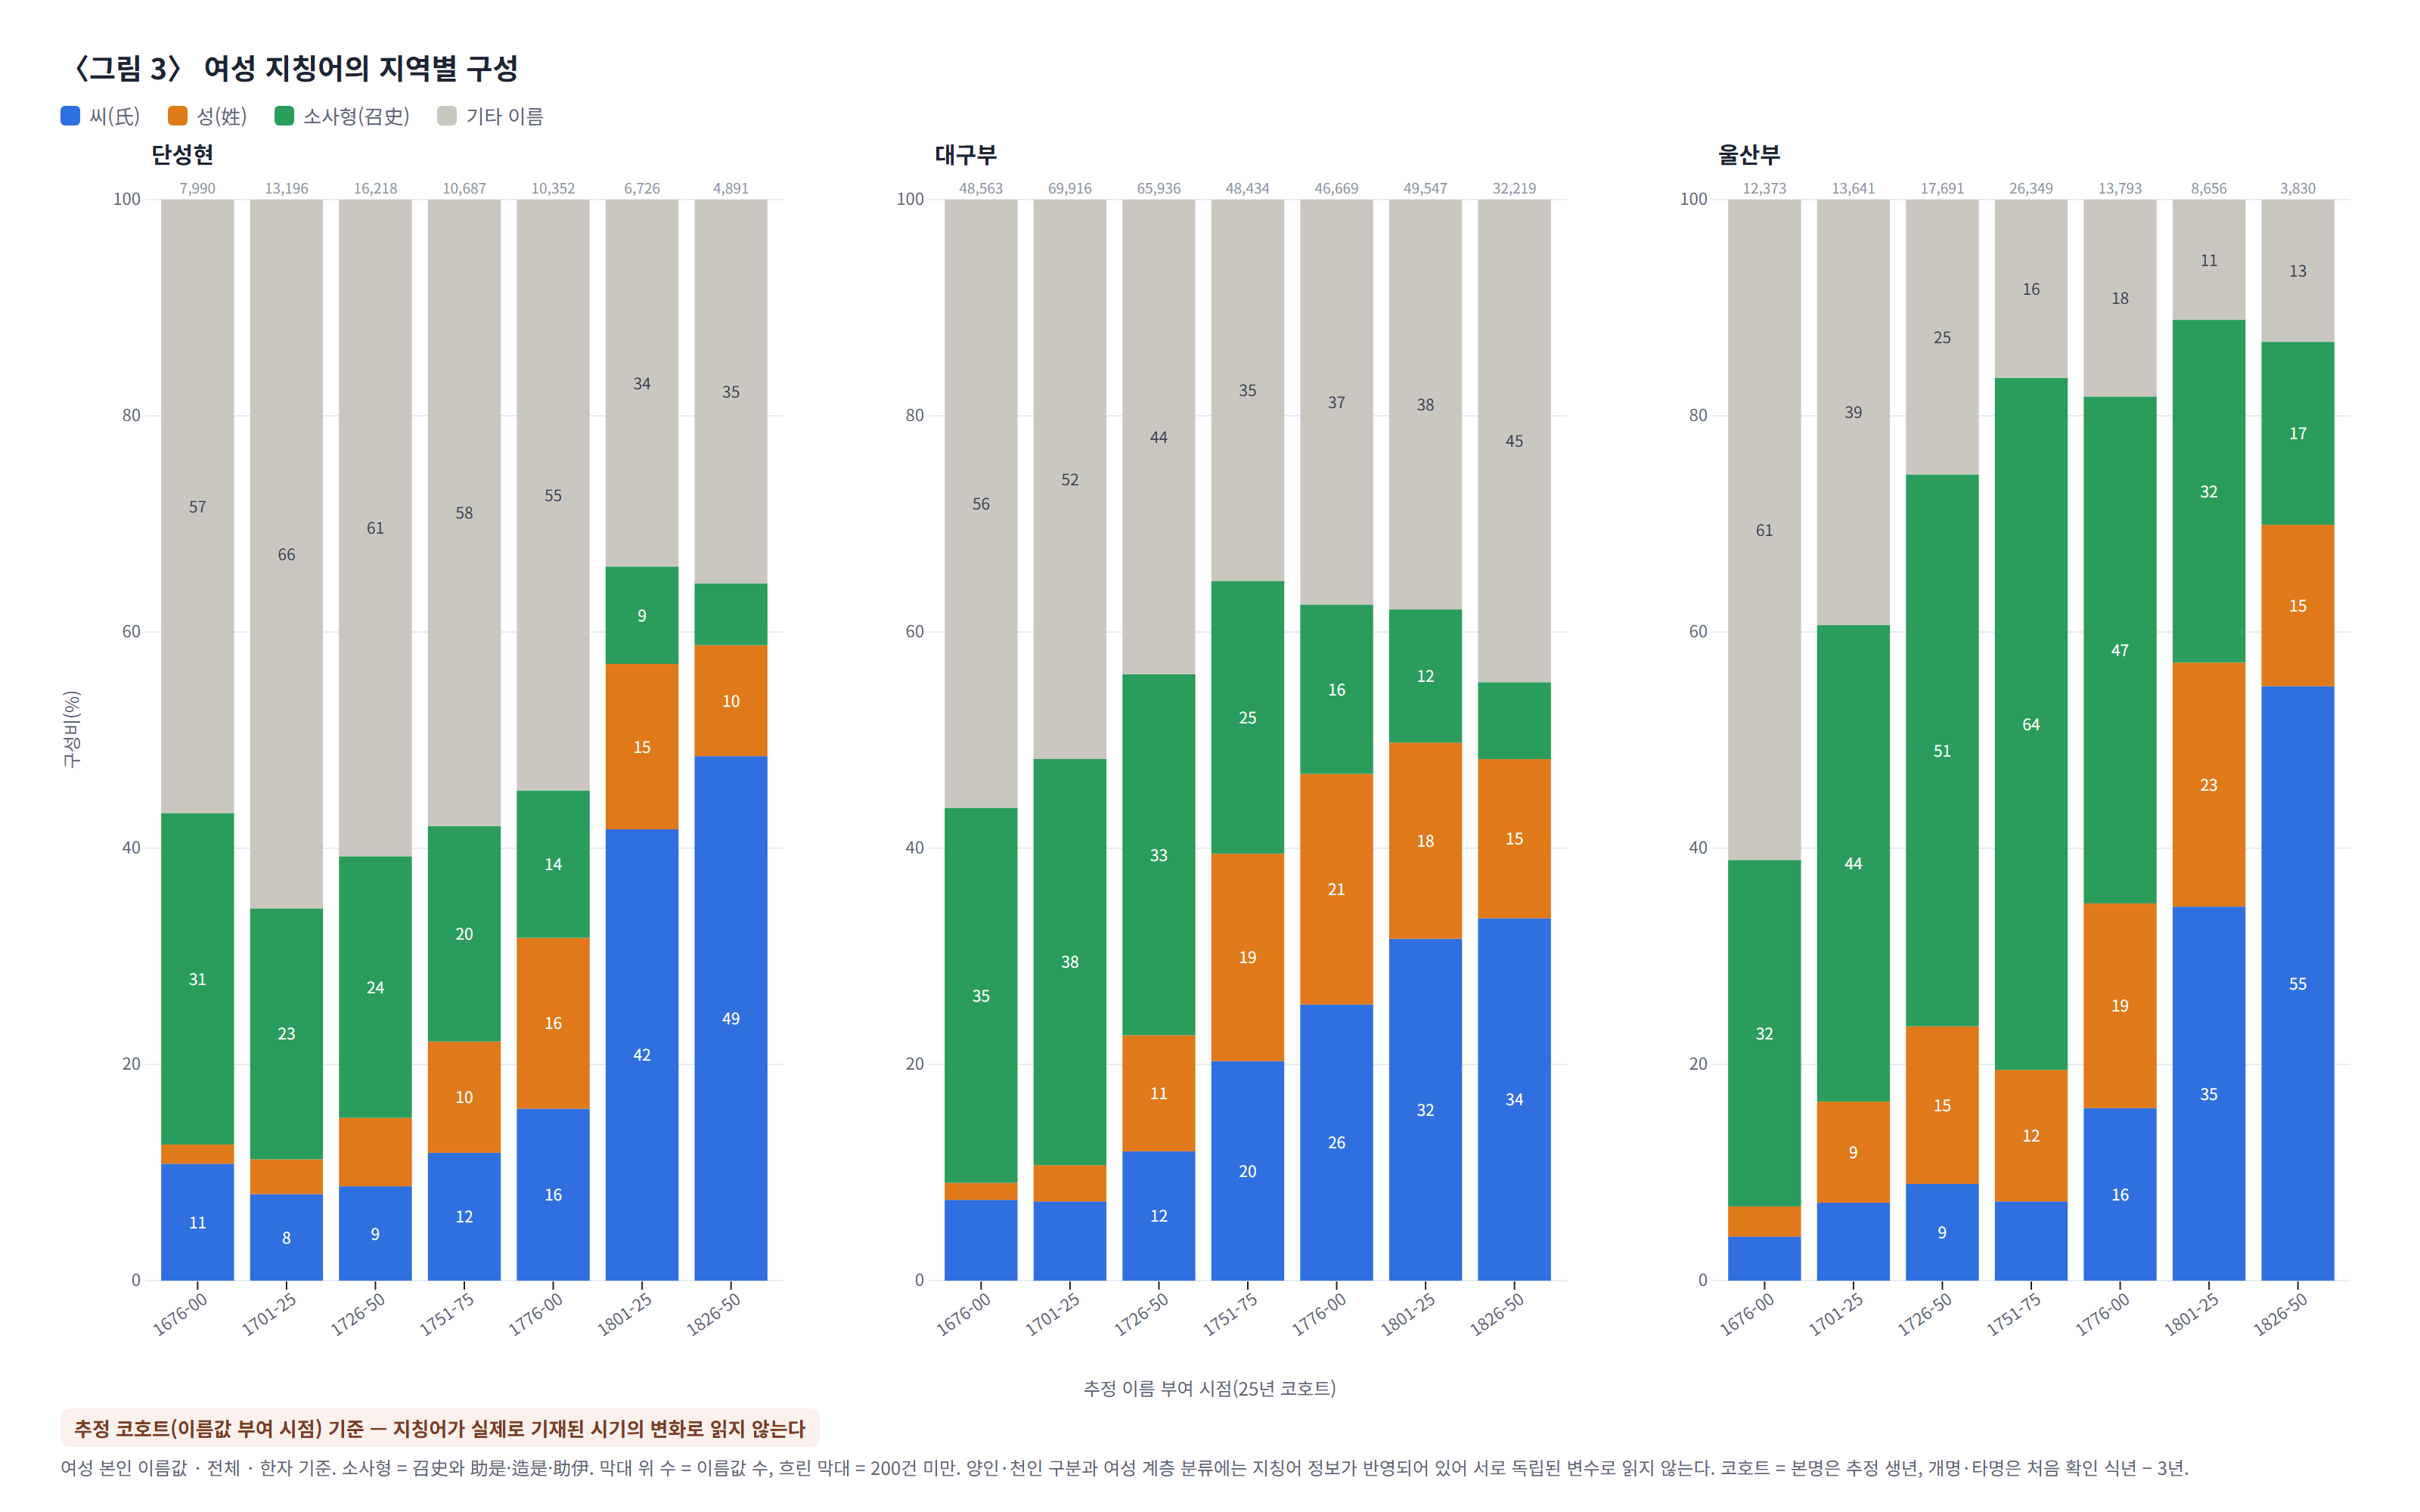
〈그림 3〉 여성 지칭어의 지역별 구성

〈그림 3〉 여성 지칭어의 지역별 구성

요청 「氏·姓·召史형과 기타 이름형의 상대 비율을 누적 막대그래프로 제시. 추정 코호트 기준임을 명확히 표시하고, 실제 기재 시기의 변화로 해석하지 않도록 주의.」

무엇을 셌나 여성 · 본인 이름값 · 한자. 소사형 = 召史와 助是·造是·助伊. 막대 위 수 = 이름값 수. 그림 안에 「추정 코호트 기준 — 지칭어가 실제로 기재된 시기의 변화로 읽지 않는다」를 적었다. 기재 식년을 기준으로 본 그림은 아래 추가 그림 (라).

원고 표와 최신 값 (표 11 · 표 12)
표 11 — 지역별 여성 인명에서 주요 지칭어의 코호트별 구성(한자, 전체)

|---|---|---|---|

코호트지역원고 이름값 · 씨 · 성 · 소사형 · 기타최신 이름값 · 씨 · 성 · 소사형 · 기타
1676-1700단성현7,874 · 10.8% · 1.7% · 30.4% · 57.0%7,990 · 10.8% · 1.8% · 30.7% · 56.7%
1676-1700대구부47,902 · 7.1% · 1.3% · 34.1% · 57.4%48,563 · 7.5% · 1.6% · 34.7% · 56.3%
1676-1700울산부12,488 · 3.9% · 2.5% · 31.2% · 62.4%12,373 · 4.1% · 2.8% · 32.1% · 61.1%
1751-1775단성현10,657 · 11.8% · 10.2% · 20.0% · 58.0%10,687 · 11.8% · 10.3% · 19.9% · 57.9%
1751-1775대구부47,530 · 20.4% · 19.2% · 25.3% · 35.2%48,434 · 20.3% · 19.2% · 25.2% · 35.3%
1751-1775울산부26,377 · 7.3% · 12.0% · 63.8% · 16.9%26,349 · 7.3% · 12.2% · 64.0% · 16.5%
1826-1850단성현4,877 · 48.9% · 10.4% · 5.7% · 35.1%4,891 · 48.5% · 10.3% · 5.7% · 35.5%
1826-1850대구부31,670 · 34.5% · 15.3% · 7.6% · 42.6%32,219 · 33.5% · 14.7% · 7.1% · 44.6%
1826-1850울산부3,605 · 59.2% · 15.8% · 18.3% · 6.7%3,830 · 55.0% · 14.9% · 16.9% · 13.2%
표 12 — 여성 인명에서 양인(Y)과 천인·미상(C+U)의 지칭어(氏·姓·召史형) 비중

원고 머리줄은 「1676-1700 | 1676-1700 | 1826-1850 양인 | 1826-1850천인」 — 앞 두 칸을 양인·천인 순으로 읽었다.

|---|---|---|

지역원고 1676-00 양인 · 천인 · 1826-50 양인 · 천인최신
단성현78.3% · 1.8% · 99.1% · 0%78.4% · 1.7% · 99.2% · 0.1%
대구부67.1% · 5.3% · 99.5% · 0.5%67.5% · 5.1% · 99.6% · 0.4%
울산부51.8% · 1.6% · 99.5% · 3.4%52.5% · 1.3% · 99.7% · 0.0%

2. 추가 그림 — 원고 Ⅳ장의 물음을 자료로

원고 Ⅳ장이 「추가로 검토할 필요」가 있다고 적은 자리와 2절의 장기 변화를 자료로 그려 본 것입니다. 논문에 바로 넣기보다 후속 연구의 출발점으로 쓰시도록 만들었습니다. 각 그림의 「이 상태로 열기」에서 지역·계층·코호트·이름 등을 바꿔 볼 수 있습니다.

(가) 이름자의 흐름

원고 Ⅳ장 2절 「이름자의 사용 양상을 구체적으로 이해하기 위해서는 개별 한자의 빈도와 순위가 장기간에 걸쳐 어떻게 변화하였는지 검토할 필요가 있다.」

같은 자료(원고 그림 1 의 이름자)를 네 가지로 그렸다. 네 그림은 맡은 일이 다르다 — 강은 큰 흐름, 순위는 최빈·순위·교체, 정점 지도는 계승의 순서와 지역의 어긋남, 작은 다중은 값과 시점.

강(ThemeRiver) — 대구부 · 최상·상층

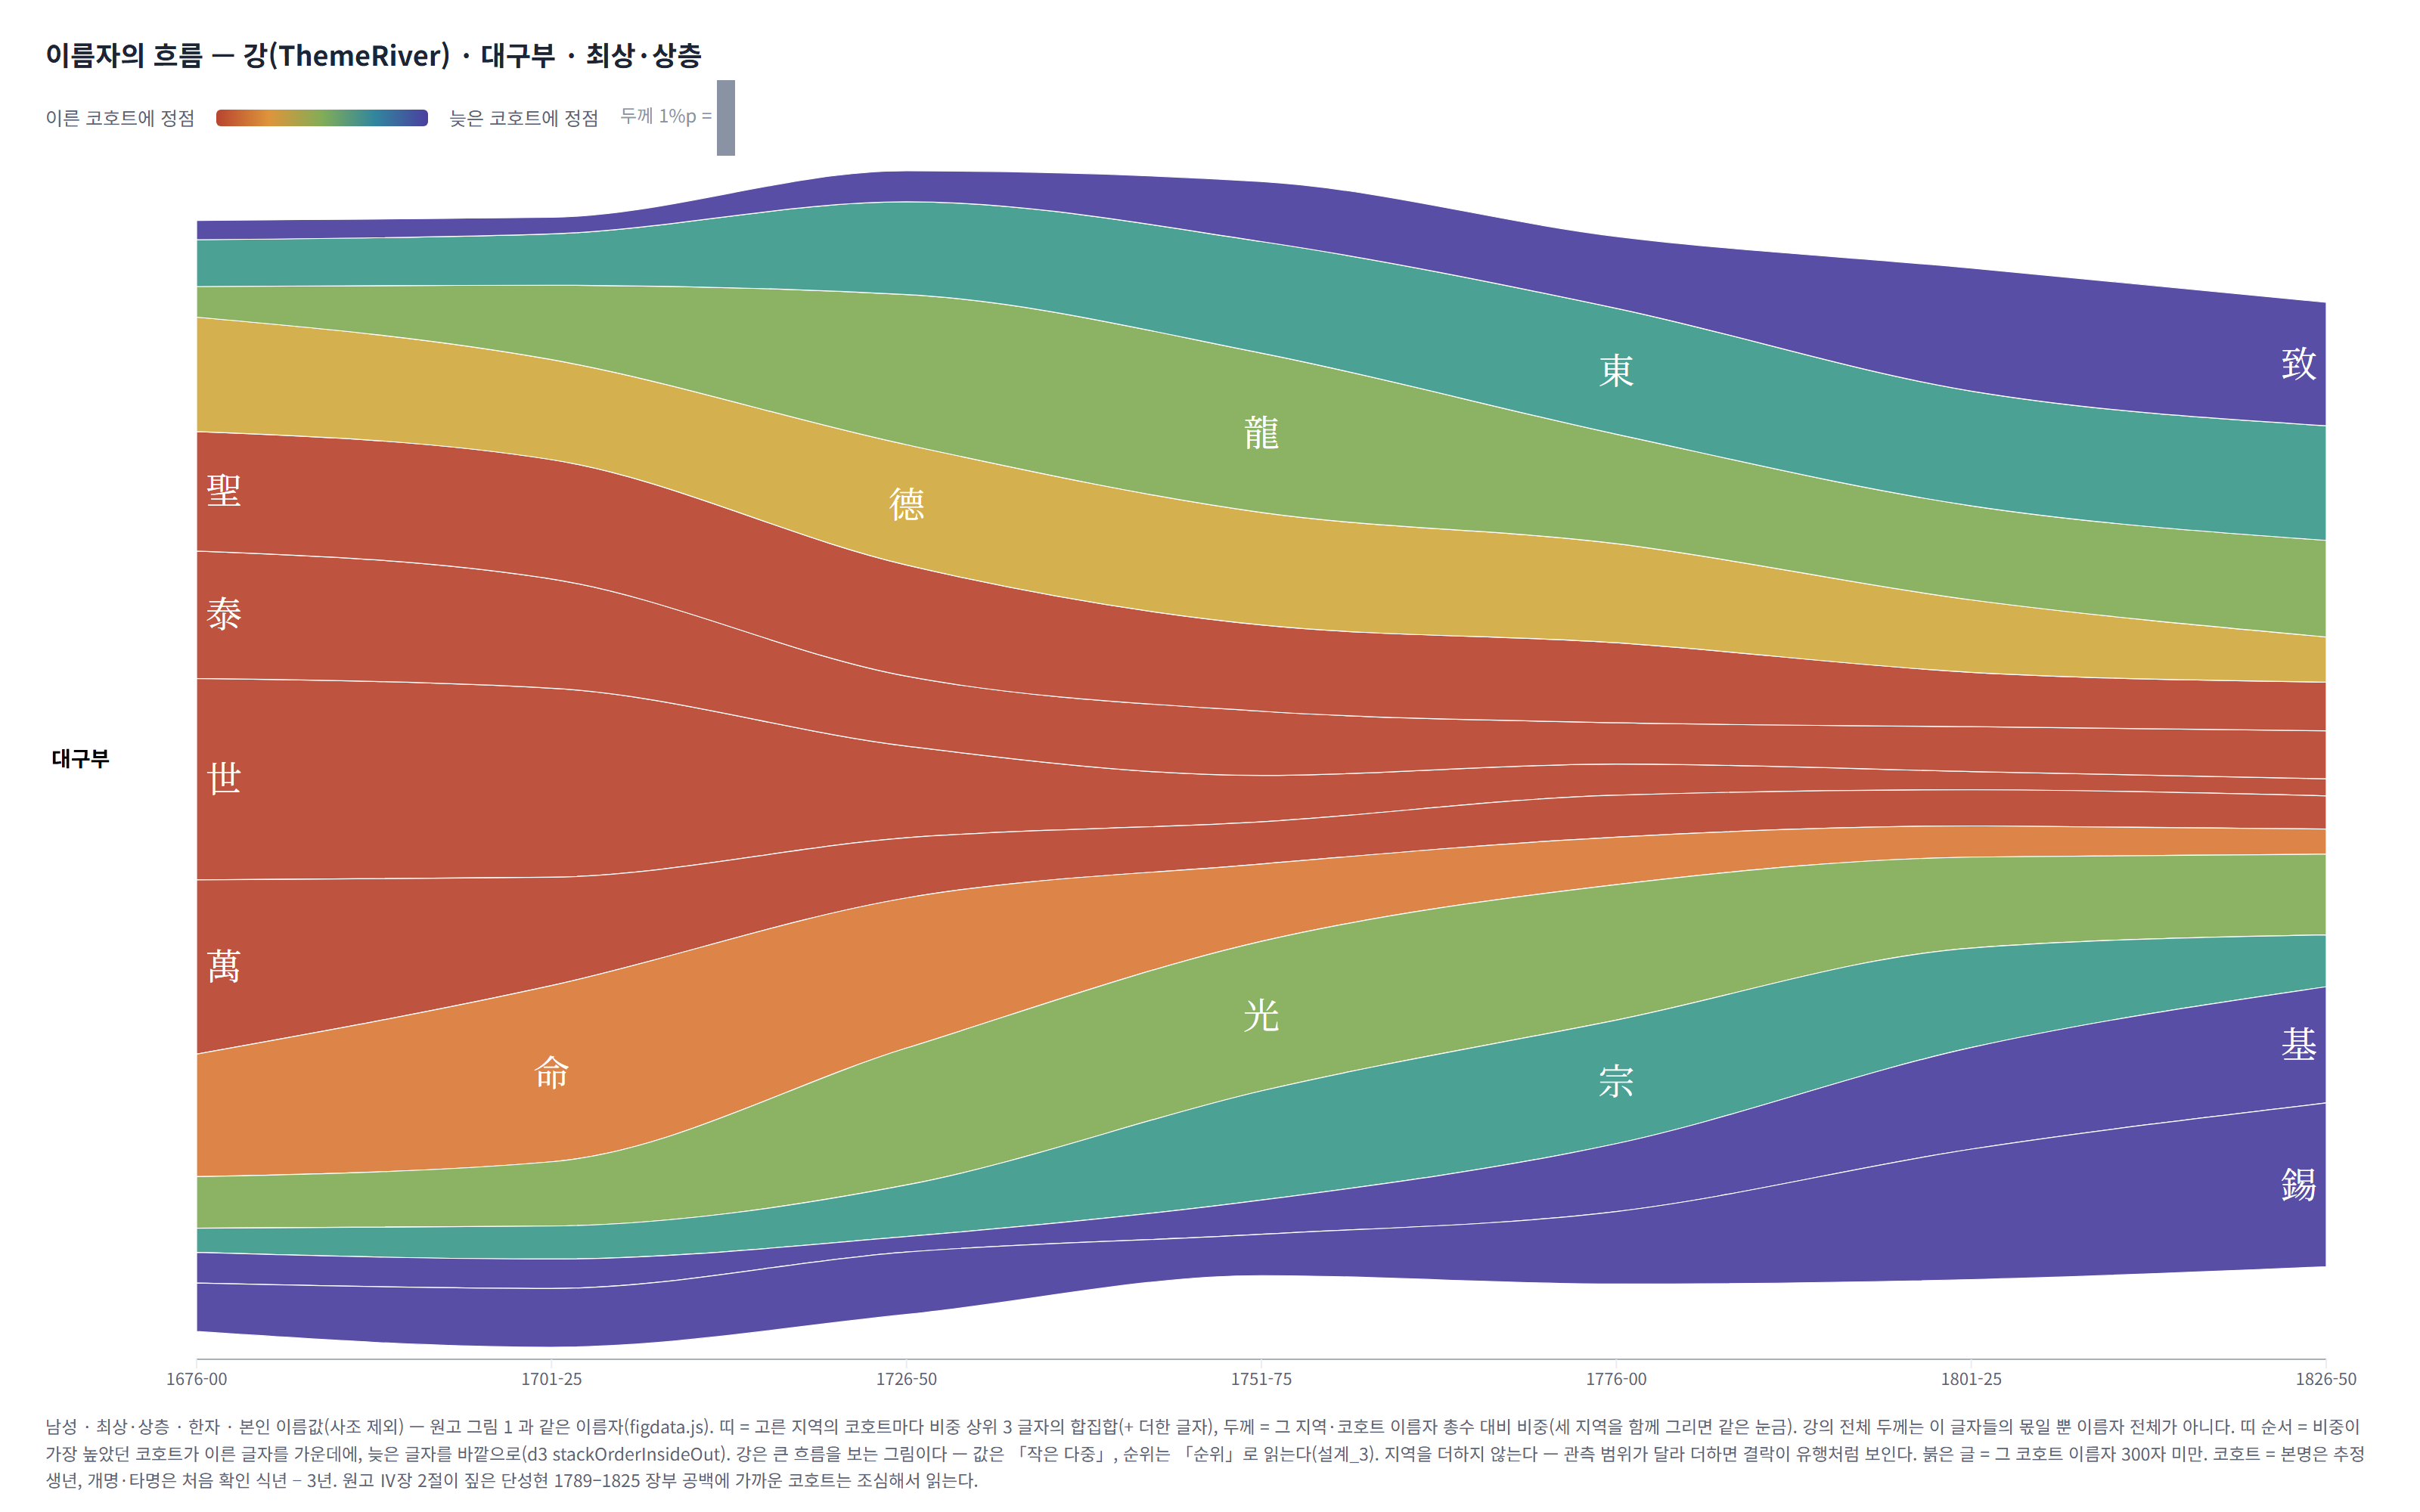
(가-1) 강(ThemeRiver) — 대구부 · 최상·상층

무엇 코호트마다 비중 상위 3 글자를 띠로 쌓았다. 띠 두께 = 그 코호트 이름자 총수 대비 비중, 색 = 그 글자의 비중이 가장 높았던 코호트(붉은색 = 이른 정점 → 보라색 = 늦은 정점).

쓰임 계승의 큰 흐름을 한눈에 — 世·萬 → 命 → 德·龍 → 光·宗·東 → 錫·致·基. 발표나 개관에 쓴다.

주의 띠 두께로는 정확한 값을 읽기 어렵고 작은 값은 덜 드러난다 — 값은 (5) 작은 다중에서 읽는다. 강 전체의 두께는 이 글자들의 몫일 뿐 이름자 전체가 아니다.

강(ThemeRiver) — 세 지역 · 최상·상층

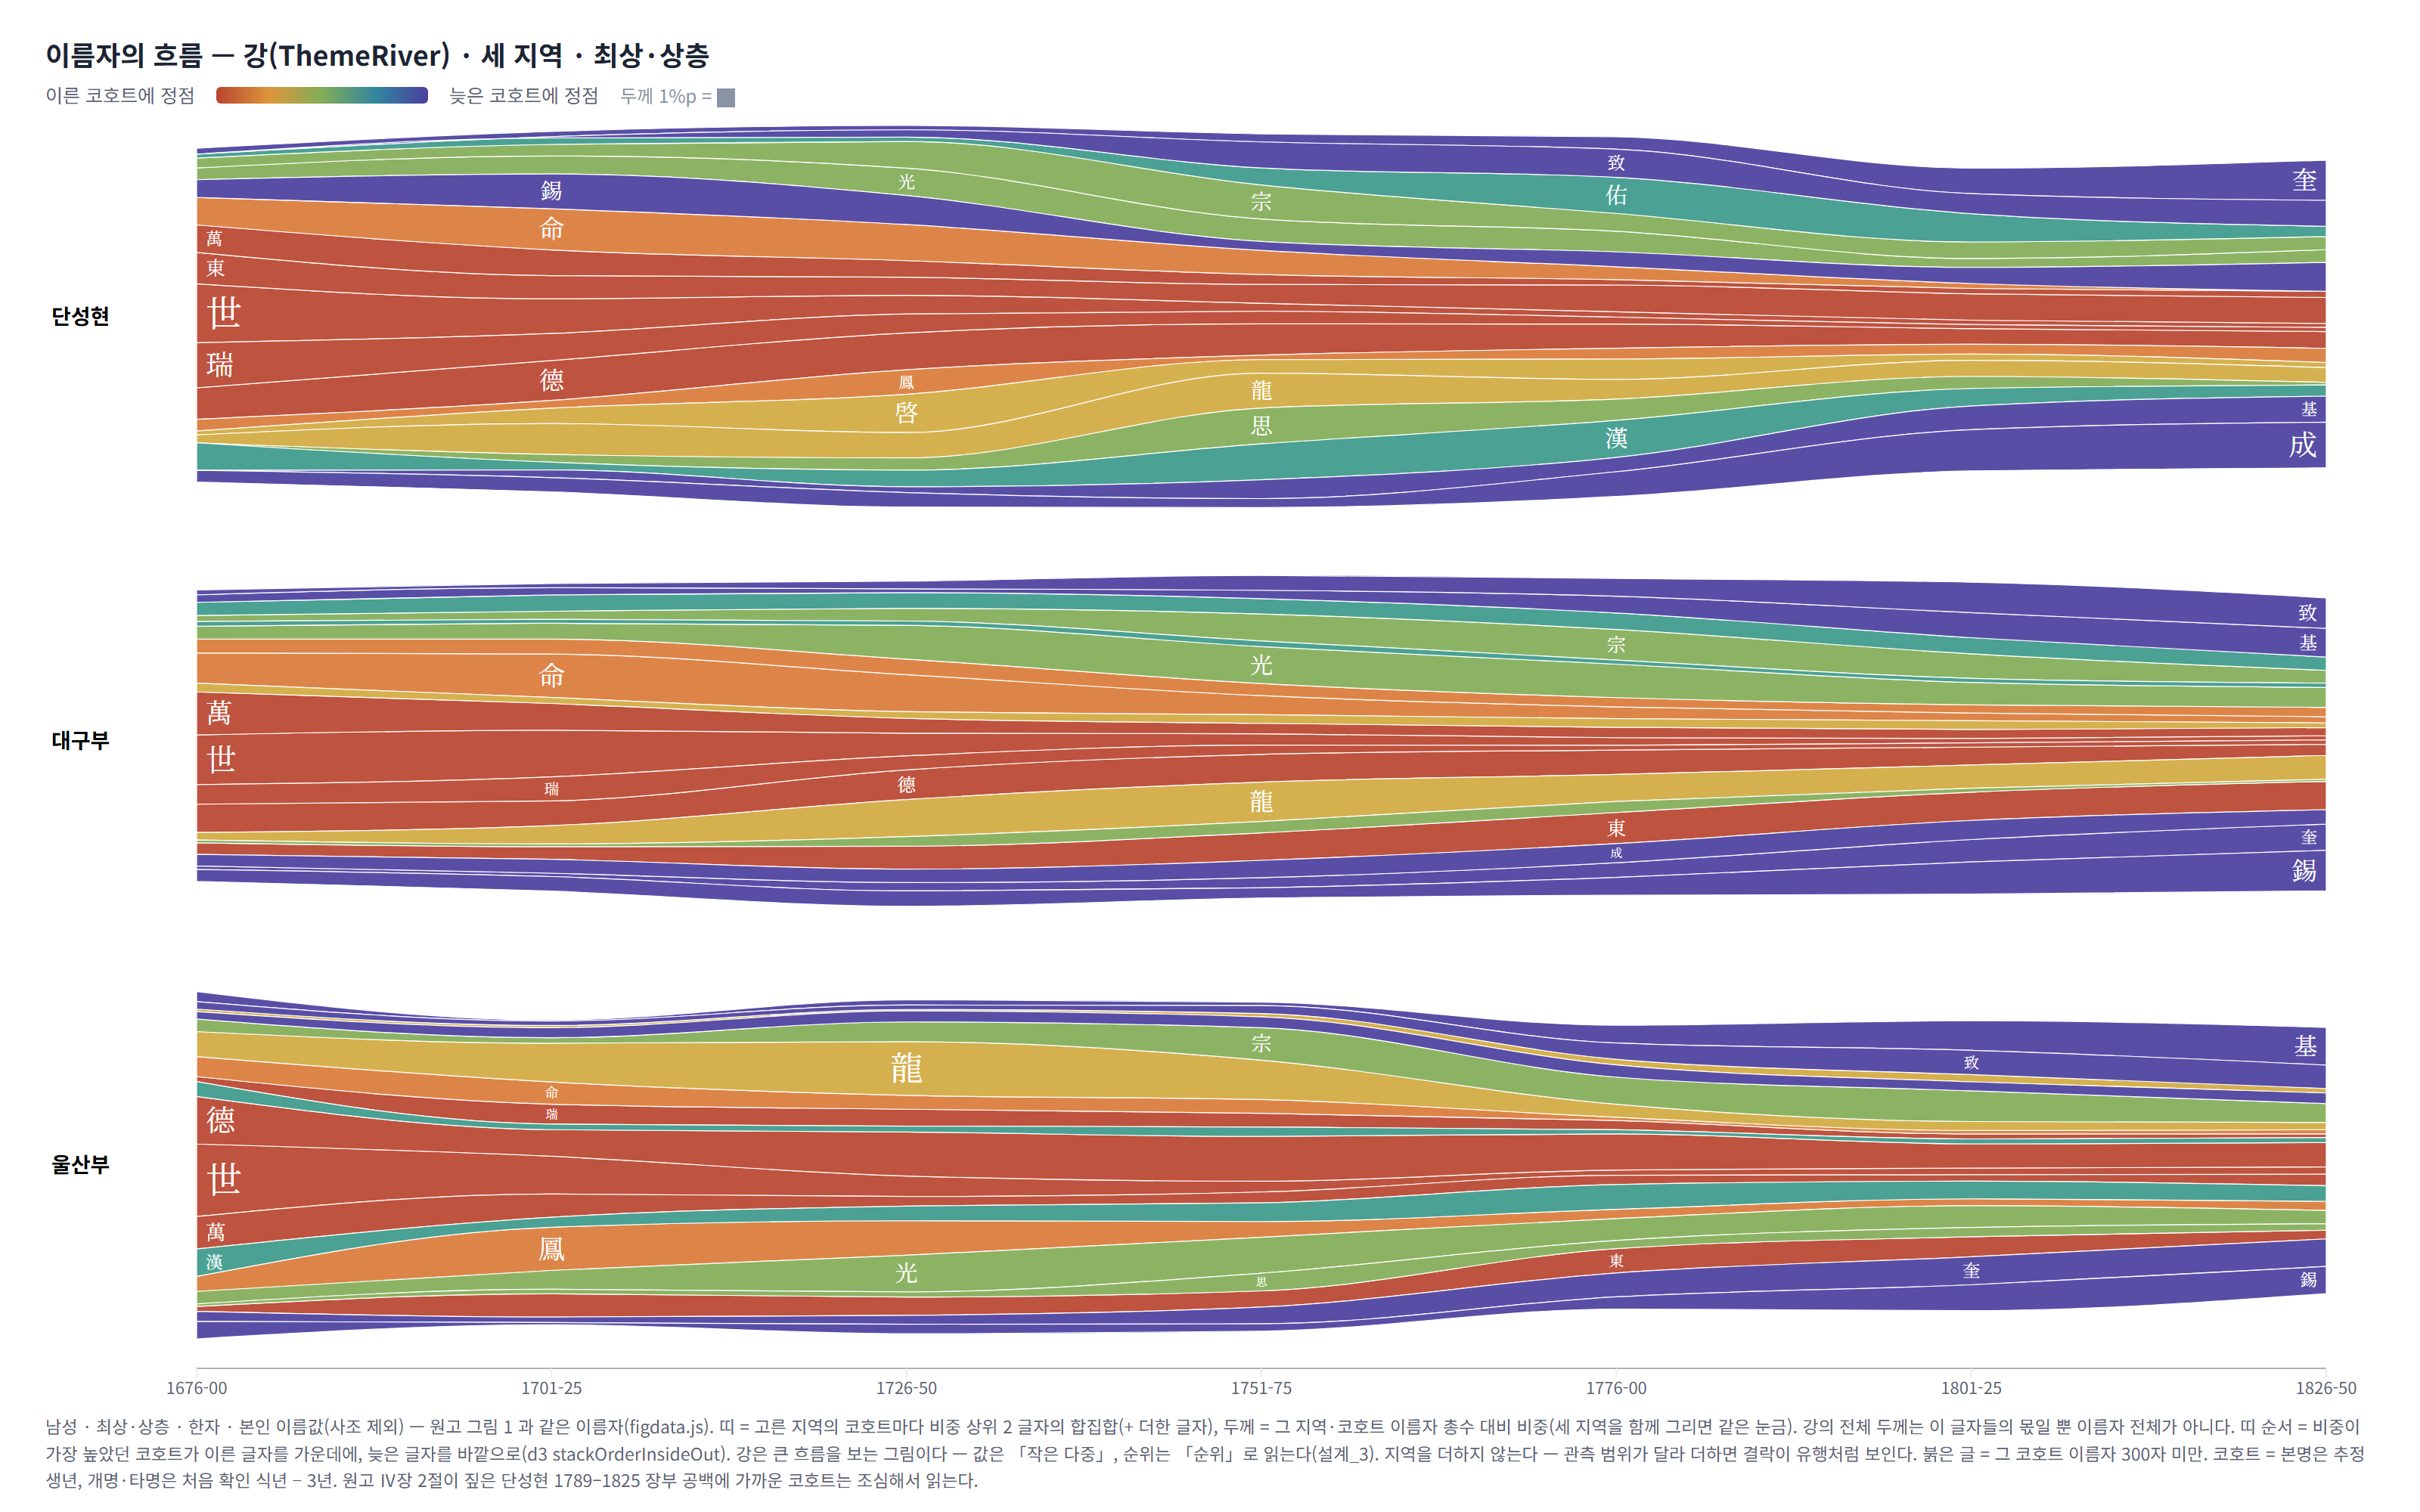
(가-2) 강(ThemeRiver) — 세 지역 · 최상·상층

무엇 같은 그림을 세 지역으로(같은 눈금), 코호트마다 상위 2 글자.

쓰임 세 지역의 계승을 나란히 — 처음에는 세 지역 모두 世 가 굵고, 끝에는 단성현 成 · 대구부 錫 · 울산부 基 가 굵다(원고 Ⅴ장 결론과 같은 모습).

주의 지역을 더하지 않았다 — 지역마다 장부가 남은 시기가 달라, 더하면 결락이 유행처럼 보인다.

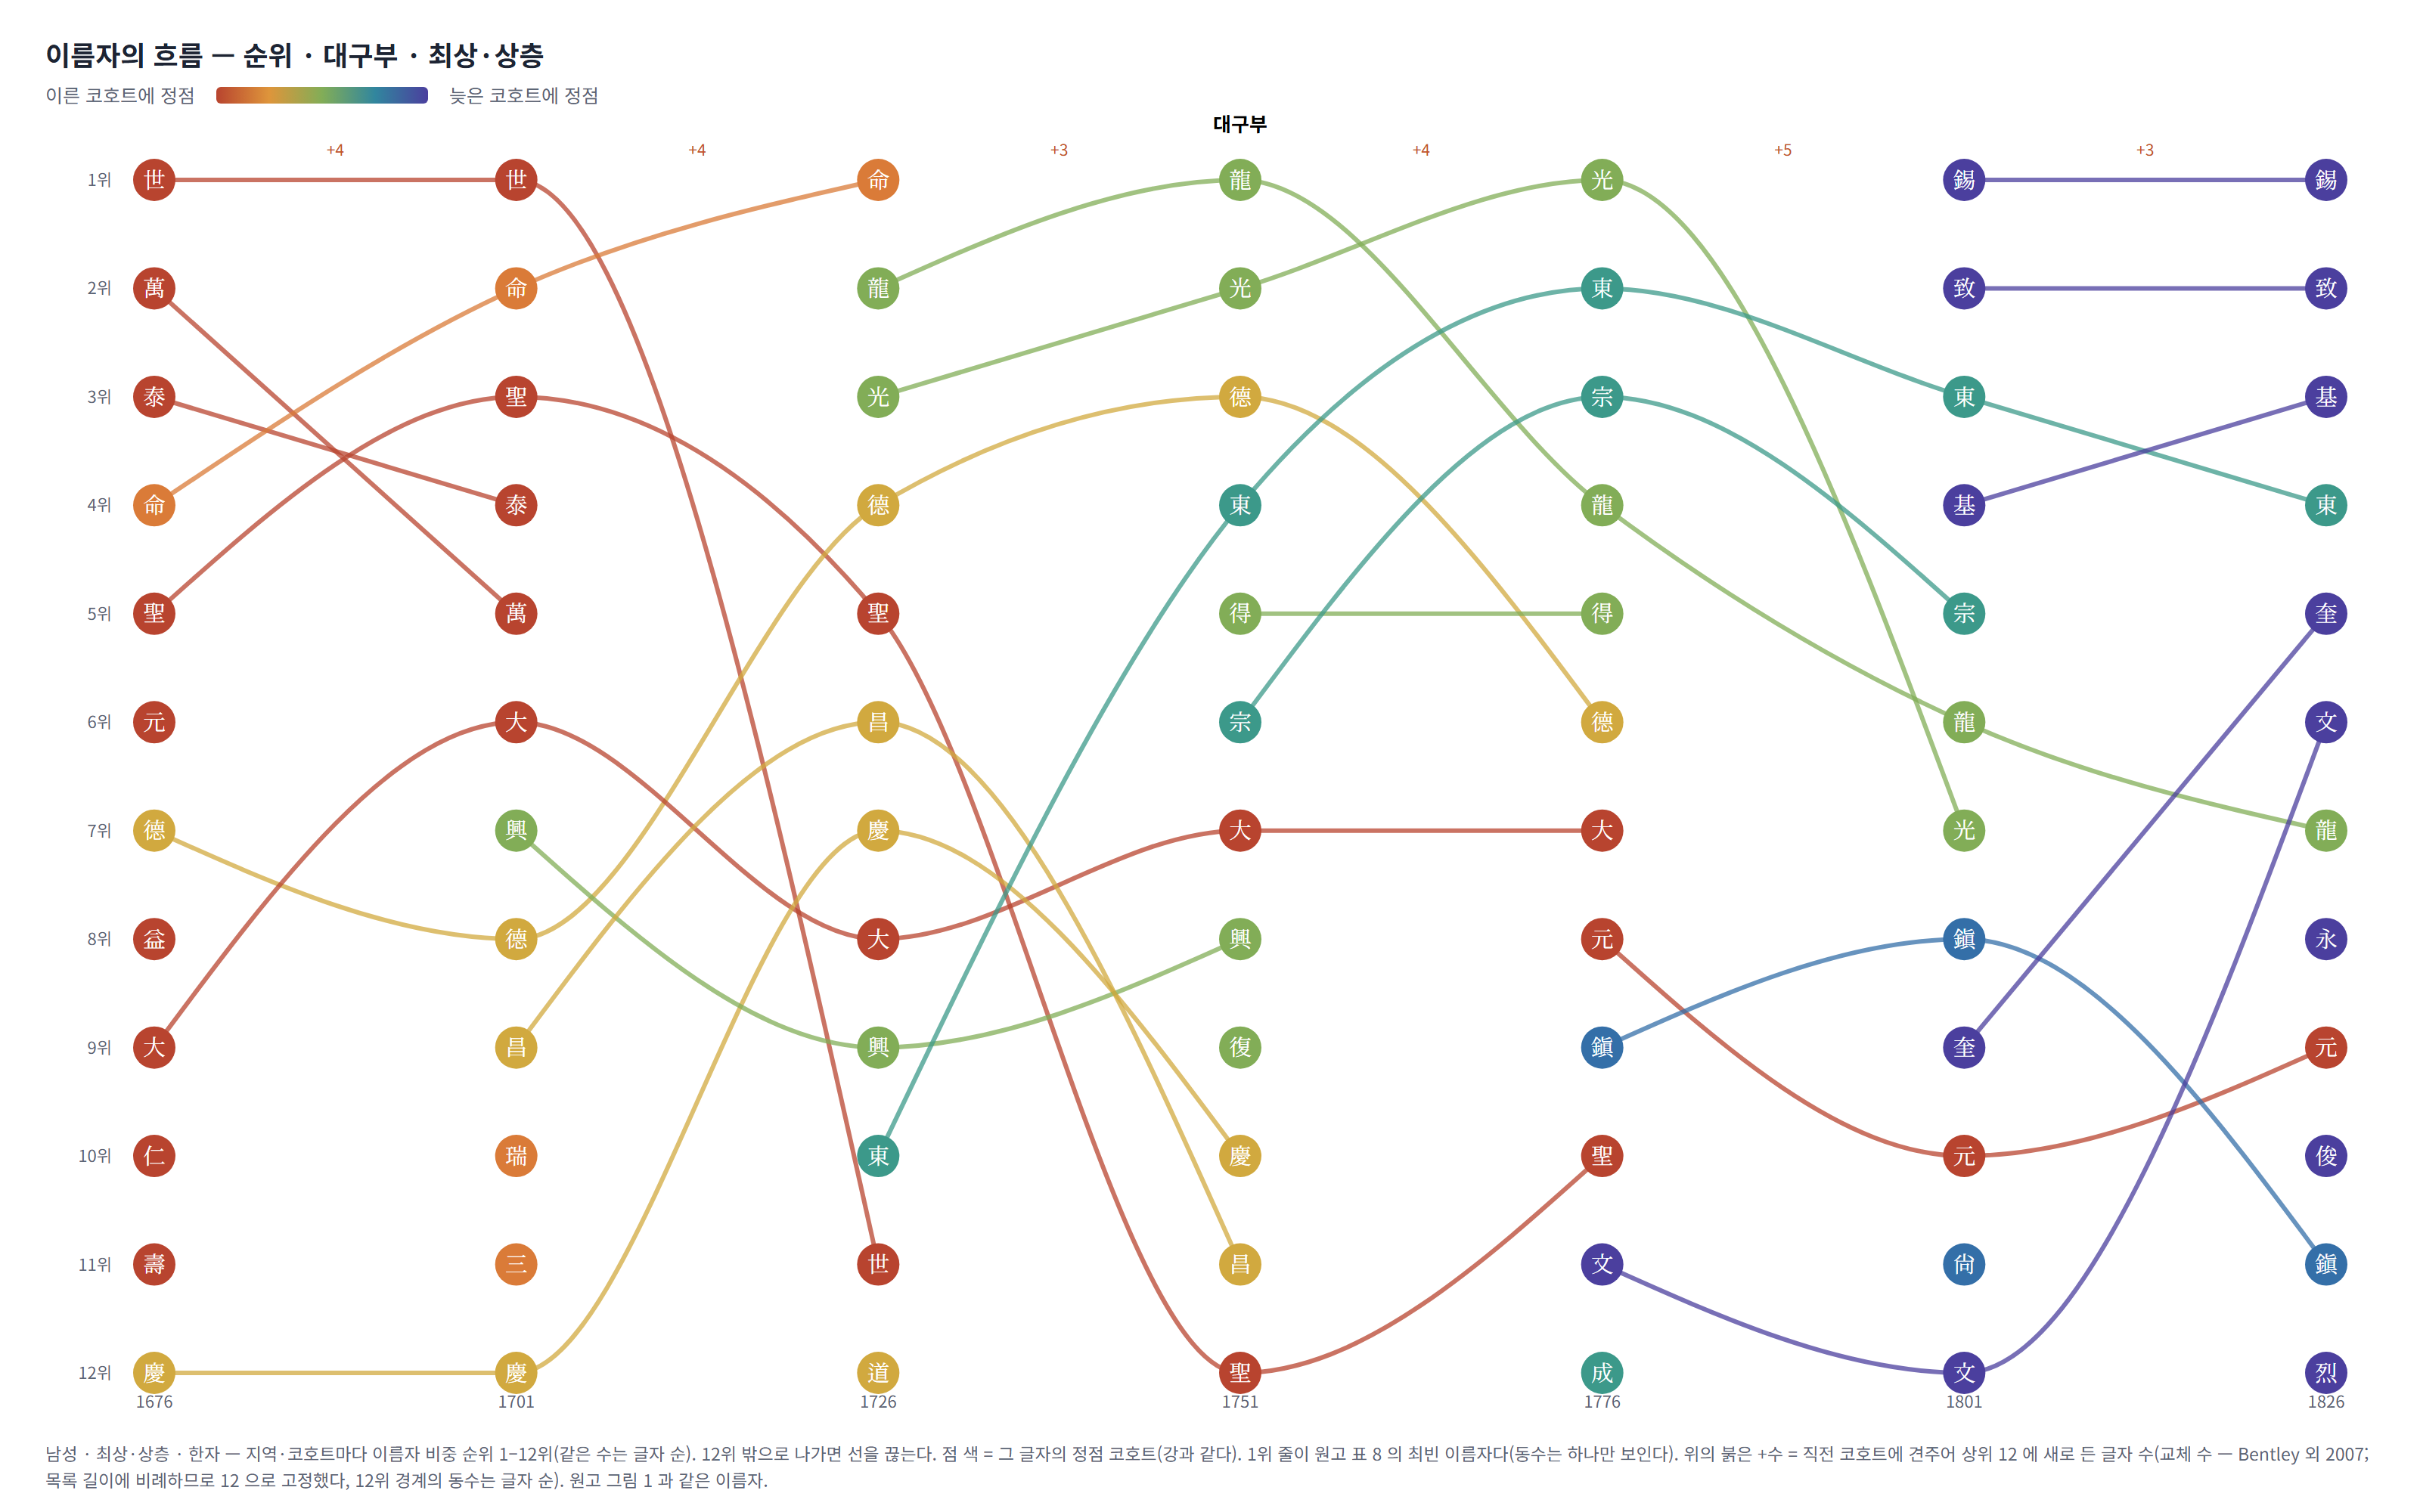
순위 — 대구부 · 최상·상층

(가-3) 순위 — 대구부 · 최상·상층

무엇 코호트마다 비중 순위 1–12위, 같은 글자를 코호트 사이로 이은 선(범프 차트). 1위 줄이 원고 표 8 의 최빈 이름자다. 위의 붉은 +n = 직전 코호트에 견주어 상위 12 에 새로 든 글자 수(교체 수).

쓰임 원고가 쓰는 「최빈」·「순위」를 그대로 보이고, 상위권이 얼마나 빨리 바뀌는지 견준다 — 대구부는 코호트마다 3–5 글자가 새로 상위 12 에 든다.

주의 순위만 보이고 비중 값은 사라진다(값은 인터랙션 페이지의 풍선 도움말). 12위 경계의 동수는 글자 순으로 정했다. 교체 수는 목록 길이에 비례하므로 12 로 고정했다.

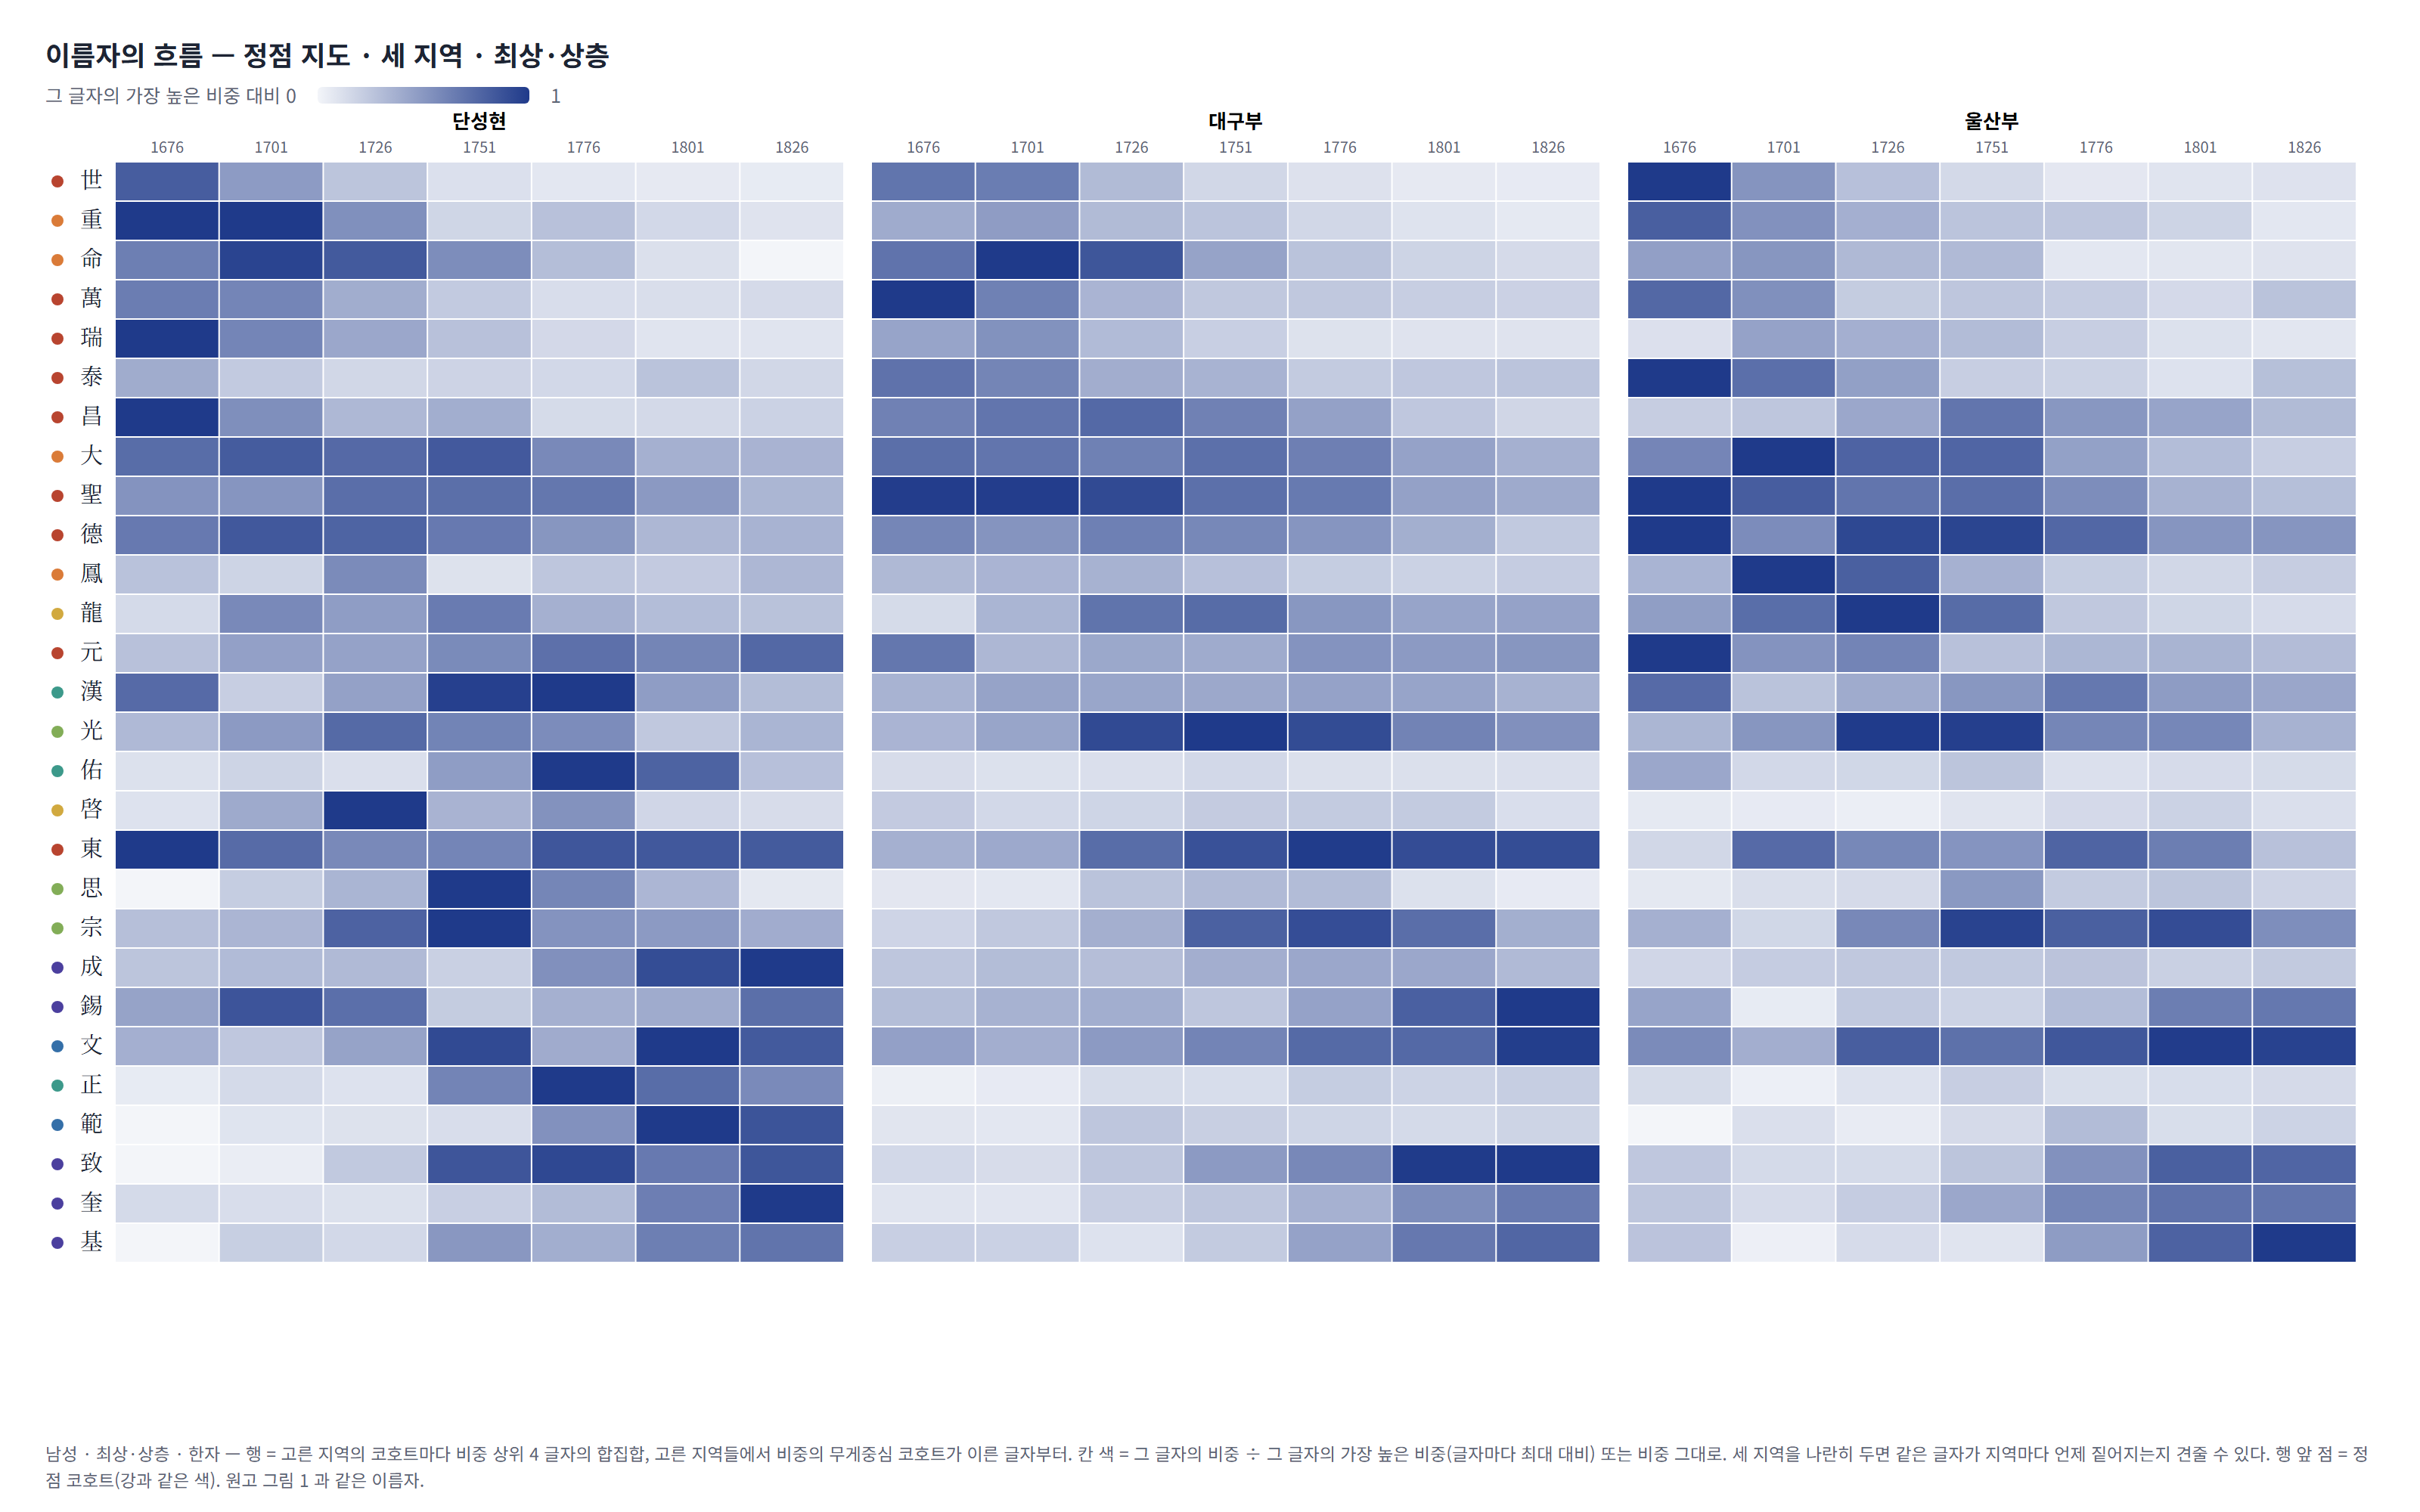
정점 지도 — 세 지역 · 최상·상층

(가-4) 정점 지도 — 세 지역 · 최상·상층

무엇 행 = 글자(코호트마다 상위 4 의 합집합), 비중이 몰린 코호트(무게중심)가 이른 글자부터 위에서 아래로. 열 = 코호트, 세 지역을 같은 행 순서로 나란히. 칸 색 = 그 글자의 비중 ÷ 그 글자의 가장 높은 비중.

쓰임 계승이 왼쪽 위에서 오른쪽 아래로 이어지는 대각선으로 보이고, 같은 글자가 지역마다 언제 짙어지는지 견줄 수 있다 — 예: 龍 은 울산부에서 1726–1750 에 가장 짙다.

주의 색은 위치보다 값 비교가 부정확하다 — 값은 작은 다중에서. 행 순서는 계열화(seriation)의 간단한 근사다.

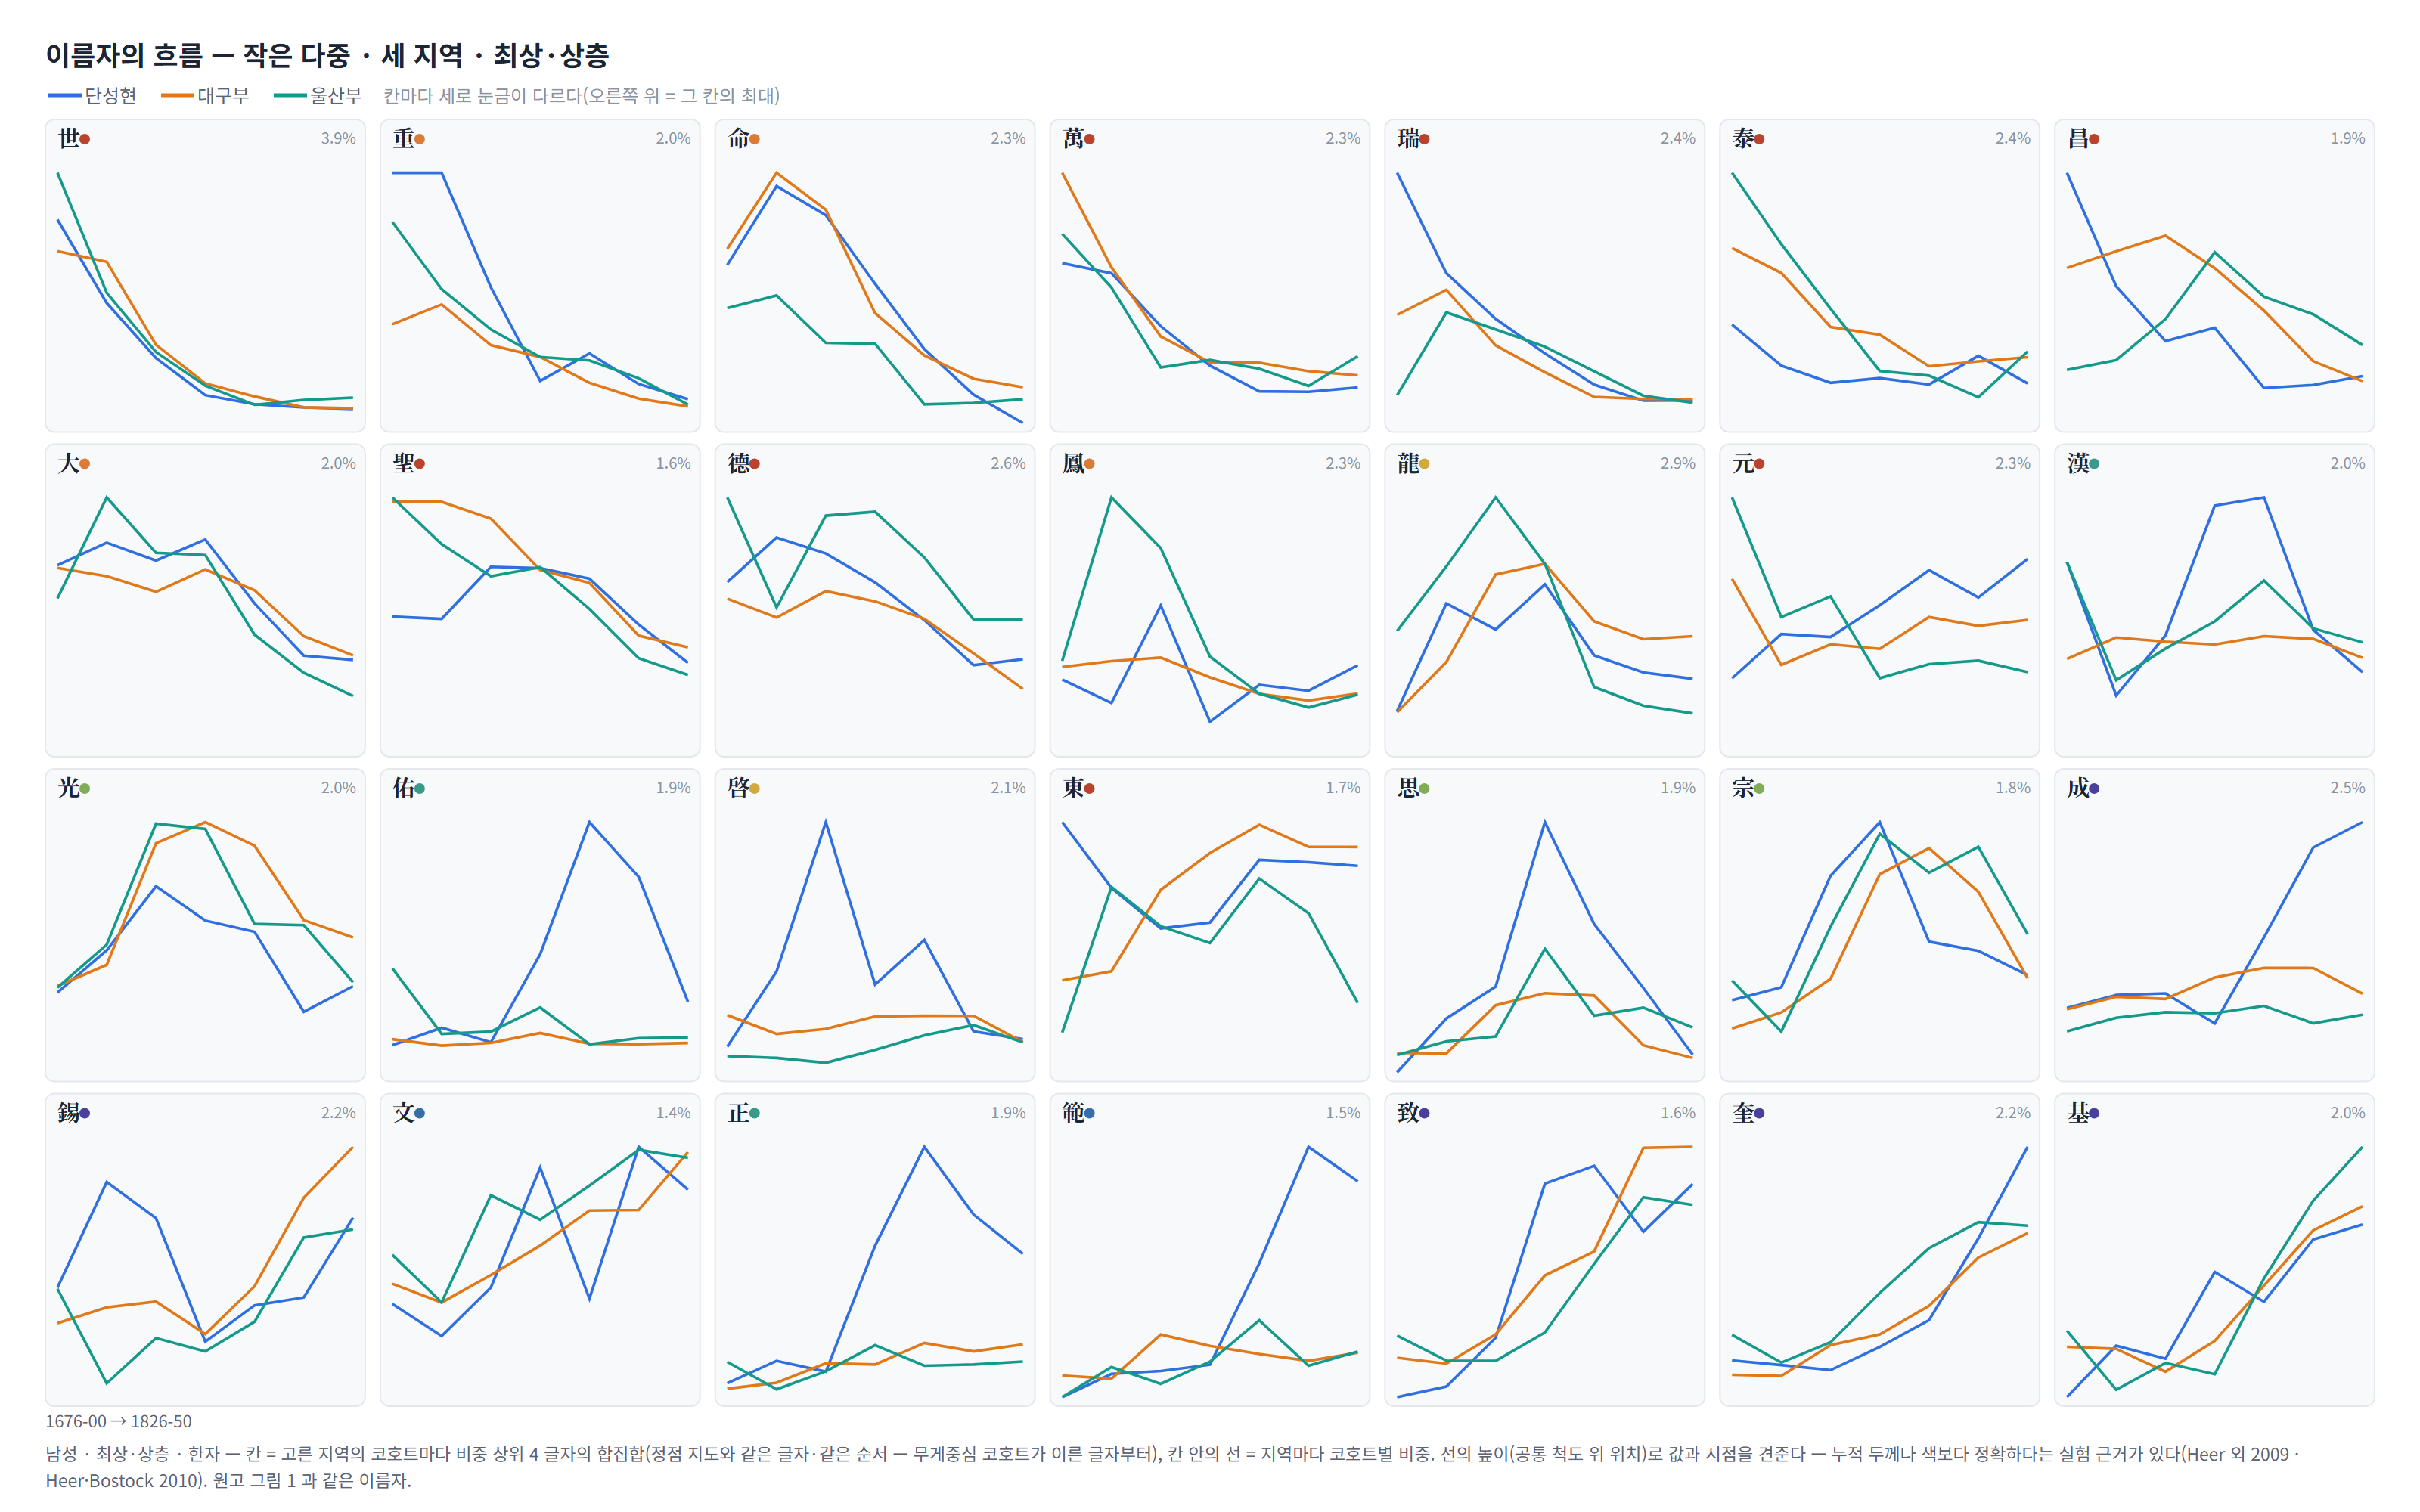
작은 다중 — 세 지역 · 최상·상층

(가-5) 작은 다중 — 세 지역 · 최상·상층

무엇 글자마다 칸 하나, 칸 안에 세 지역 선(코호트별 비중). 칸마다 세로 눈금이 다르다(오른쪽 위 수 = 그 칸의 최대).

쓰임 지역 사이에서 오르내리는 시점과 값을 견준다 — 예: 龍 은 울산부 1726–1750, 단성현·대구부 1751–1775 에 가장 높다. 成·正·範 은 단성현에서만 오른다.

주의 칸끼리 높이를 견주지 말 것(눈금이 다르다). 인터랙션 페이지에서 눈금을 「모두 같게」로 바꿔 찍을 수 있다.

(나) 글자와 가계

원고 Ⅳ장 1절 「어떤 한자가 특정 가계의 항렬자로 사용되었는지, 여러 가계에서 독립적으로 선택되었는지, 또는 특정한 시기에 널리 사용된 글자였는지를 확인하기 위해서는 개별 인물의 가족관계와 이름의 조합을 추가로 검토할 필요가 있다.」
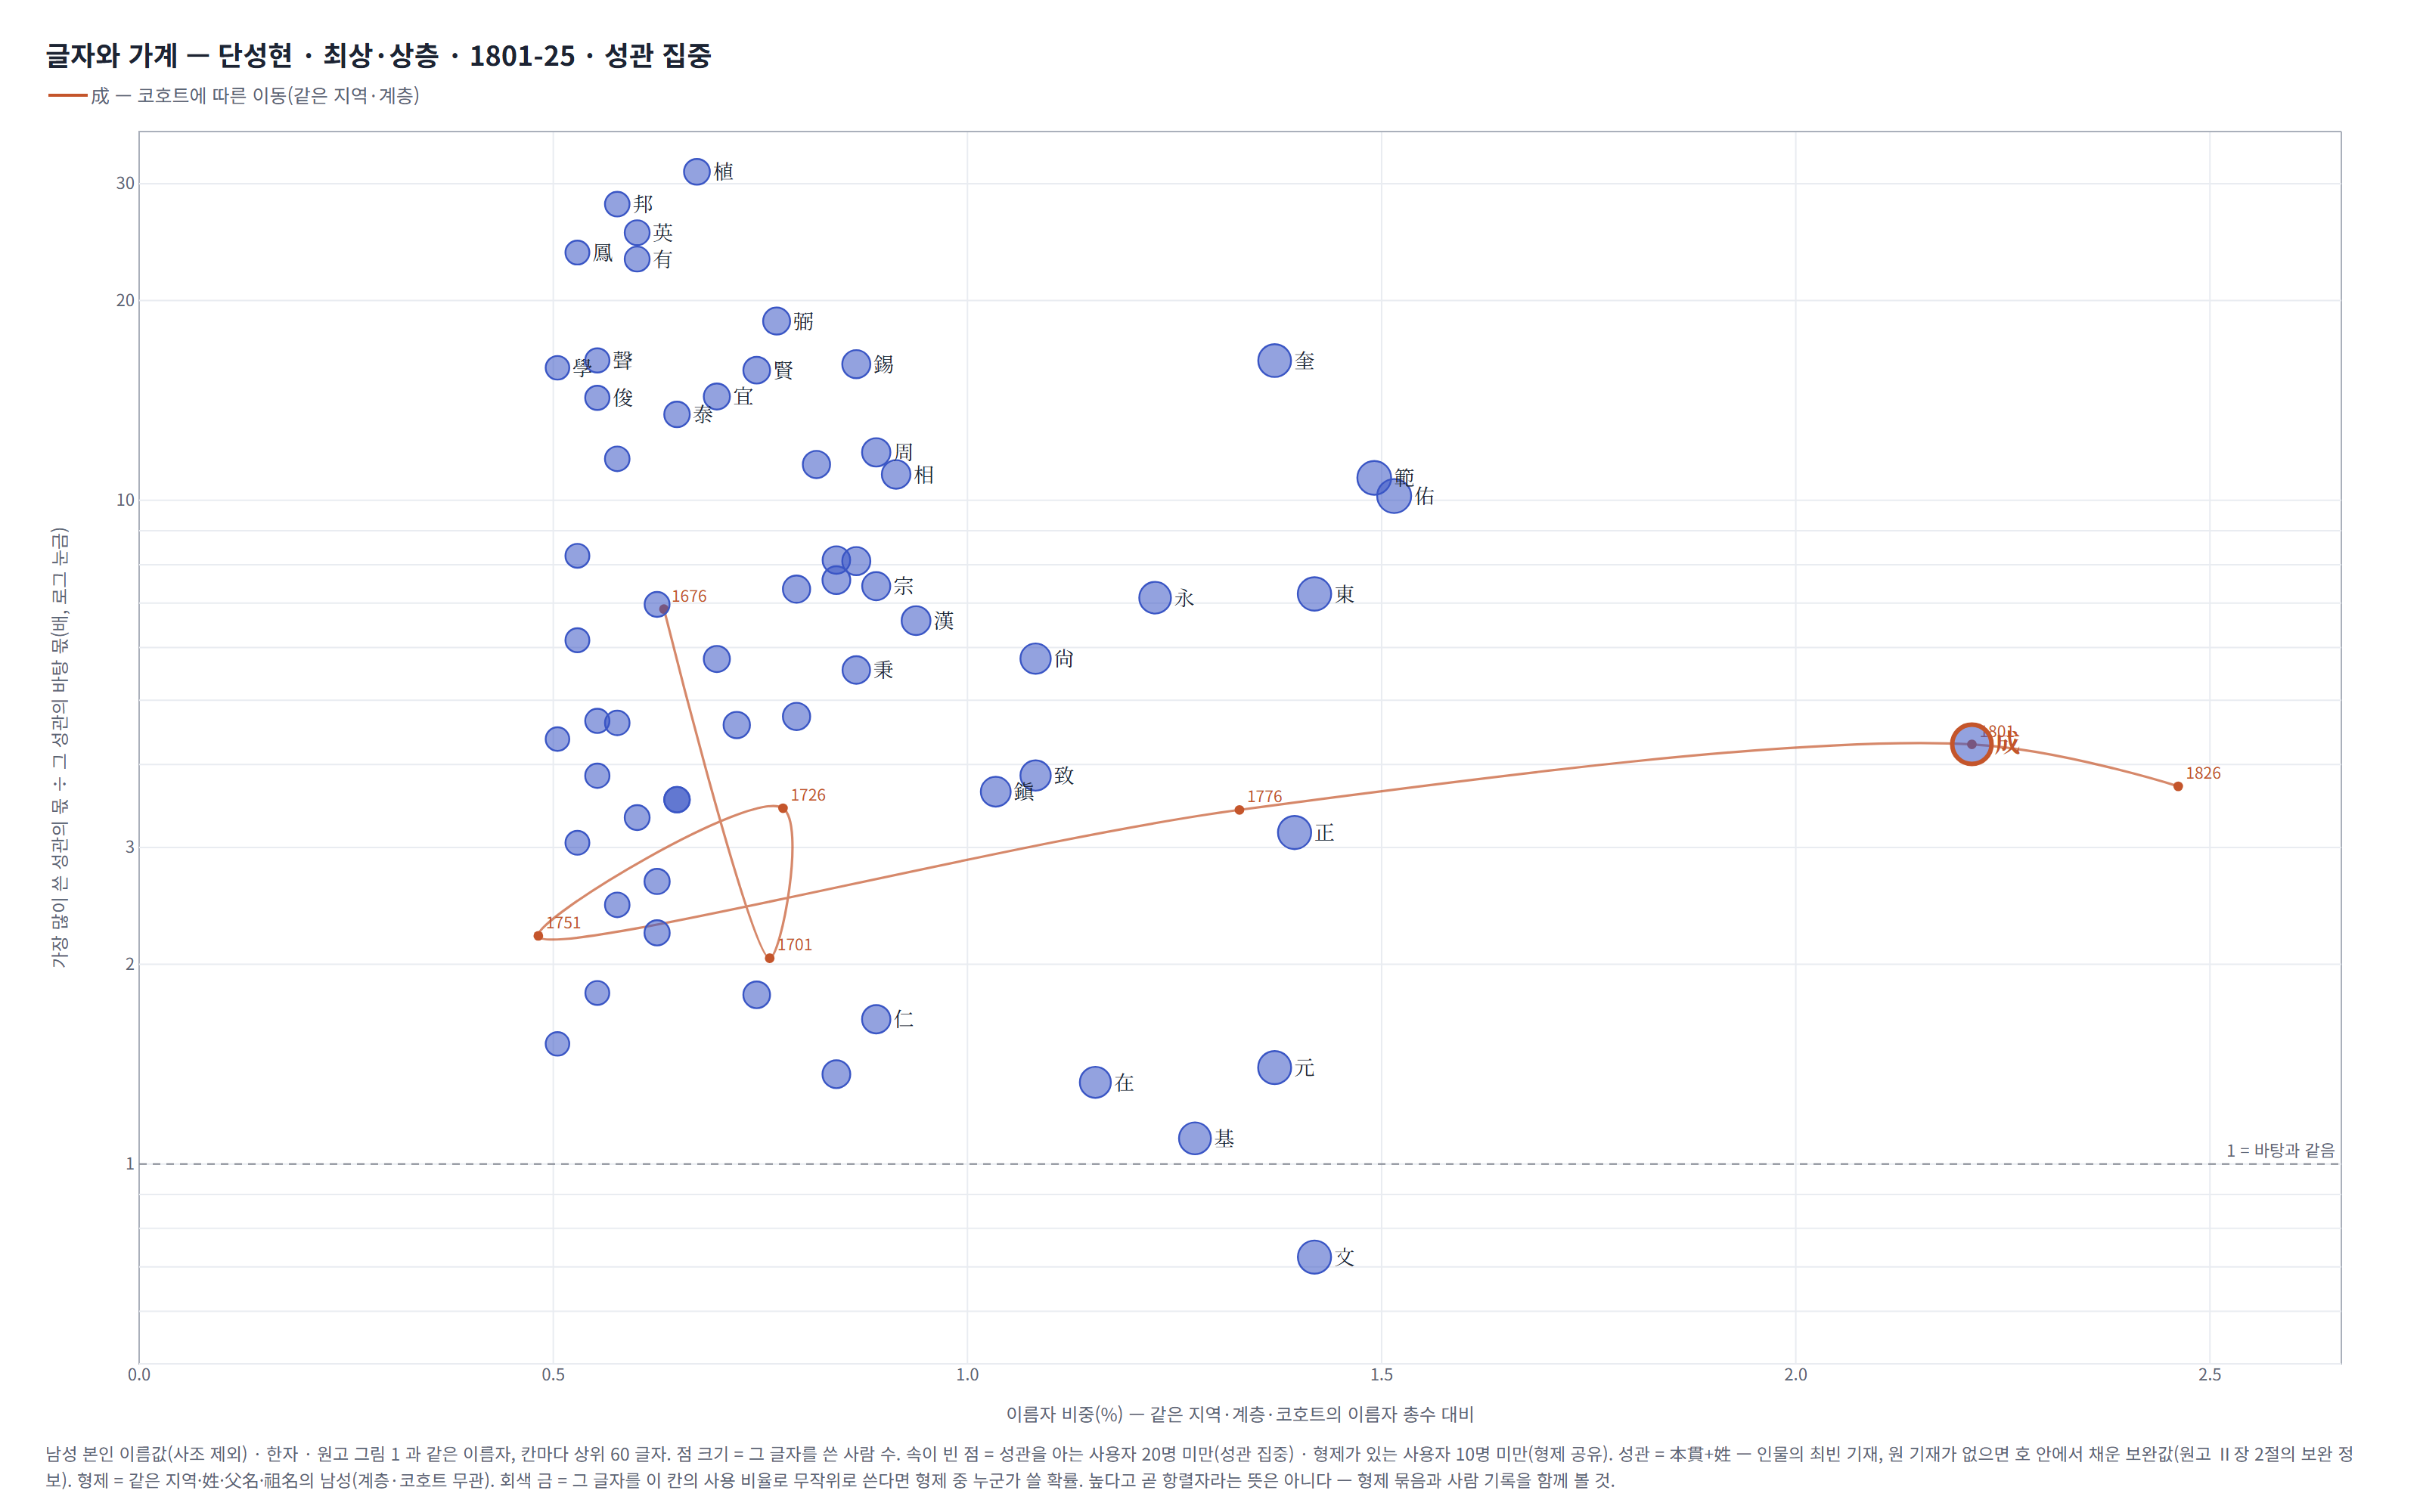
글자와 가계 — 단성현 · 최상·상층 · 1801–1825

(나-1) 글자와 가계 — 단성현 · 최상·상층 · 1801–1825

무엇 점 = 이 칸의 상위 60 글자. 가로 = 비중, 세로 = 그 글자를 쓴 사람 가운데 가장 많은 성관(本貫+姓)의 몫 ÷ 그 성관이 이 칸 전체에서 차지하는 몫(1 = 바탕과 같음, 로그 눈금). 붉은 선 = 고른 글자(成)가 코호트를 따라 움직인 자리. 점 크기 = 쓴 사람 수.

쓰임 한 성관에 몰린 글자(항렬자 후보)를 찾는다 — 예: 成 은 쓴 사람 91명 중 安東 權 이 49명(54%)인데, 이 칸 전체에서 安東 權 은 13% 다. 형제(같은 父名·祖名)가 있는 사용자 35명 중 20명(57.1%)은 형제도 成 을 쓴다(이 칸의 사용 비율로 셈한 우연은 약 6.5%). 성관 내역과 형제 묶음은 인터랙션 페이지의 옆 칸에서 본다.

주의 높다고 곧 항렬자는 아니다 — 형제 묶음과 사람 기록을 함께 볼 것. 성관·父名 의 일부는 호(戶) 안에서 채운 보완값이다.

(다) 이름의 생애

원고 Ⅳ장 3절 「해당 이름이 어떤 연령과 호내 위상의 인물에게 기재되었는지를 추가로 확인해야 한다.」
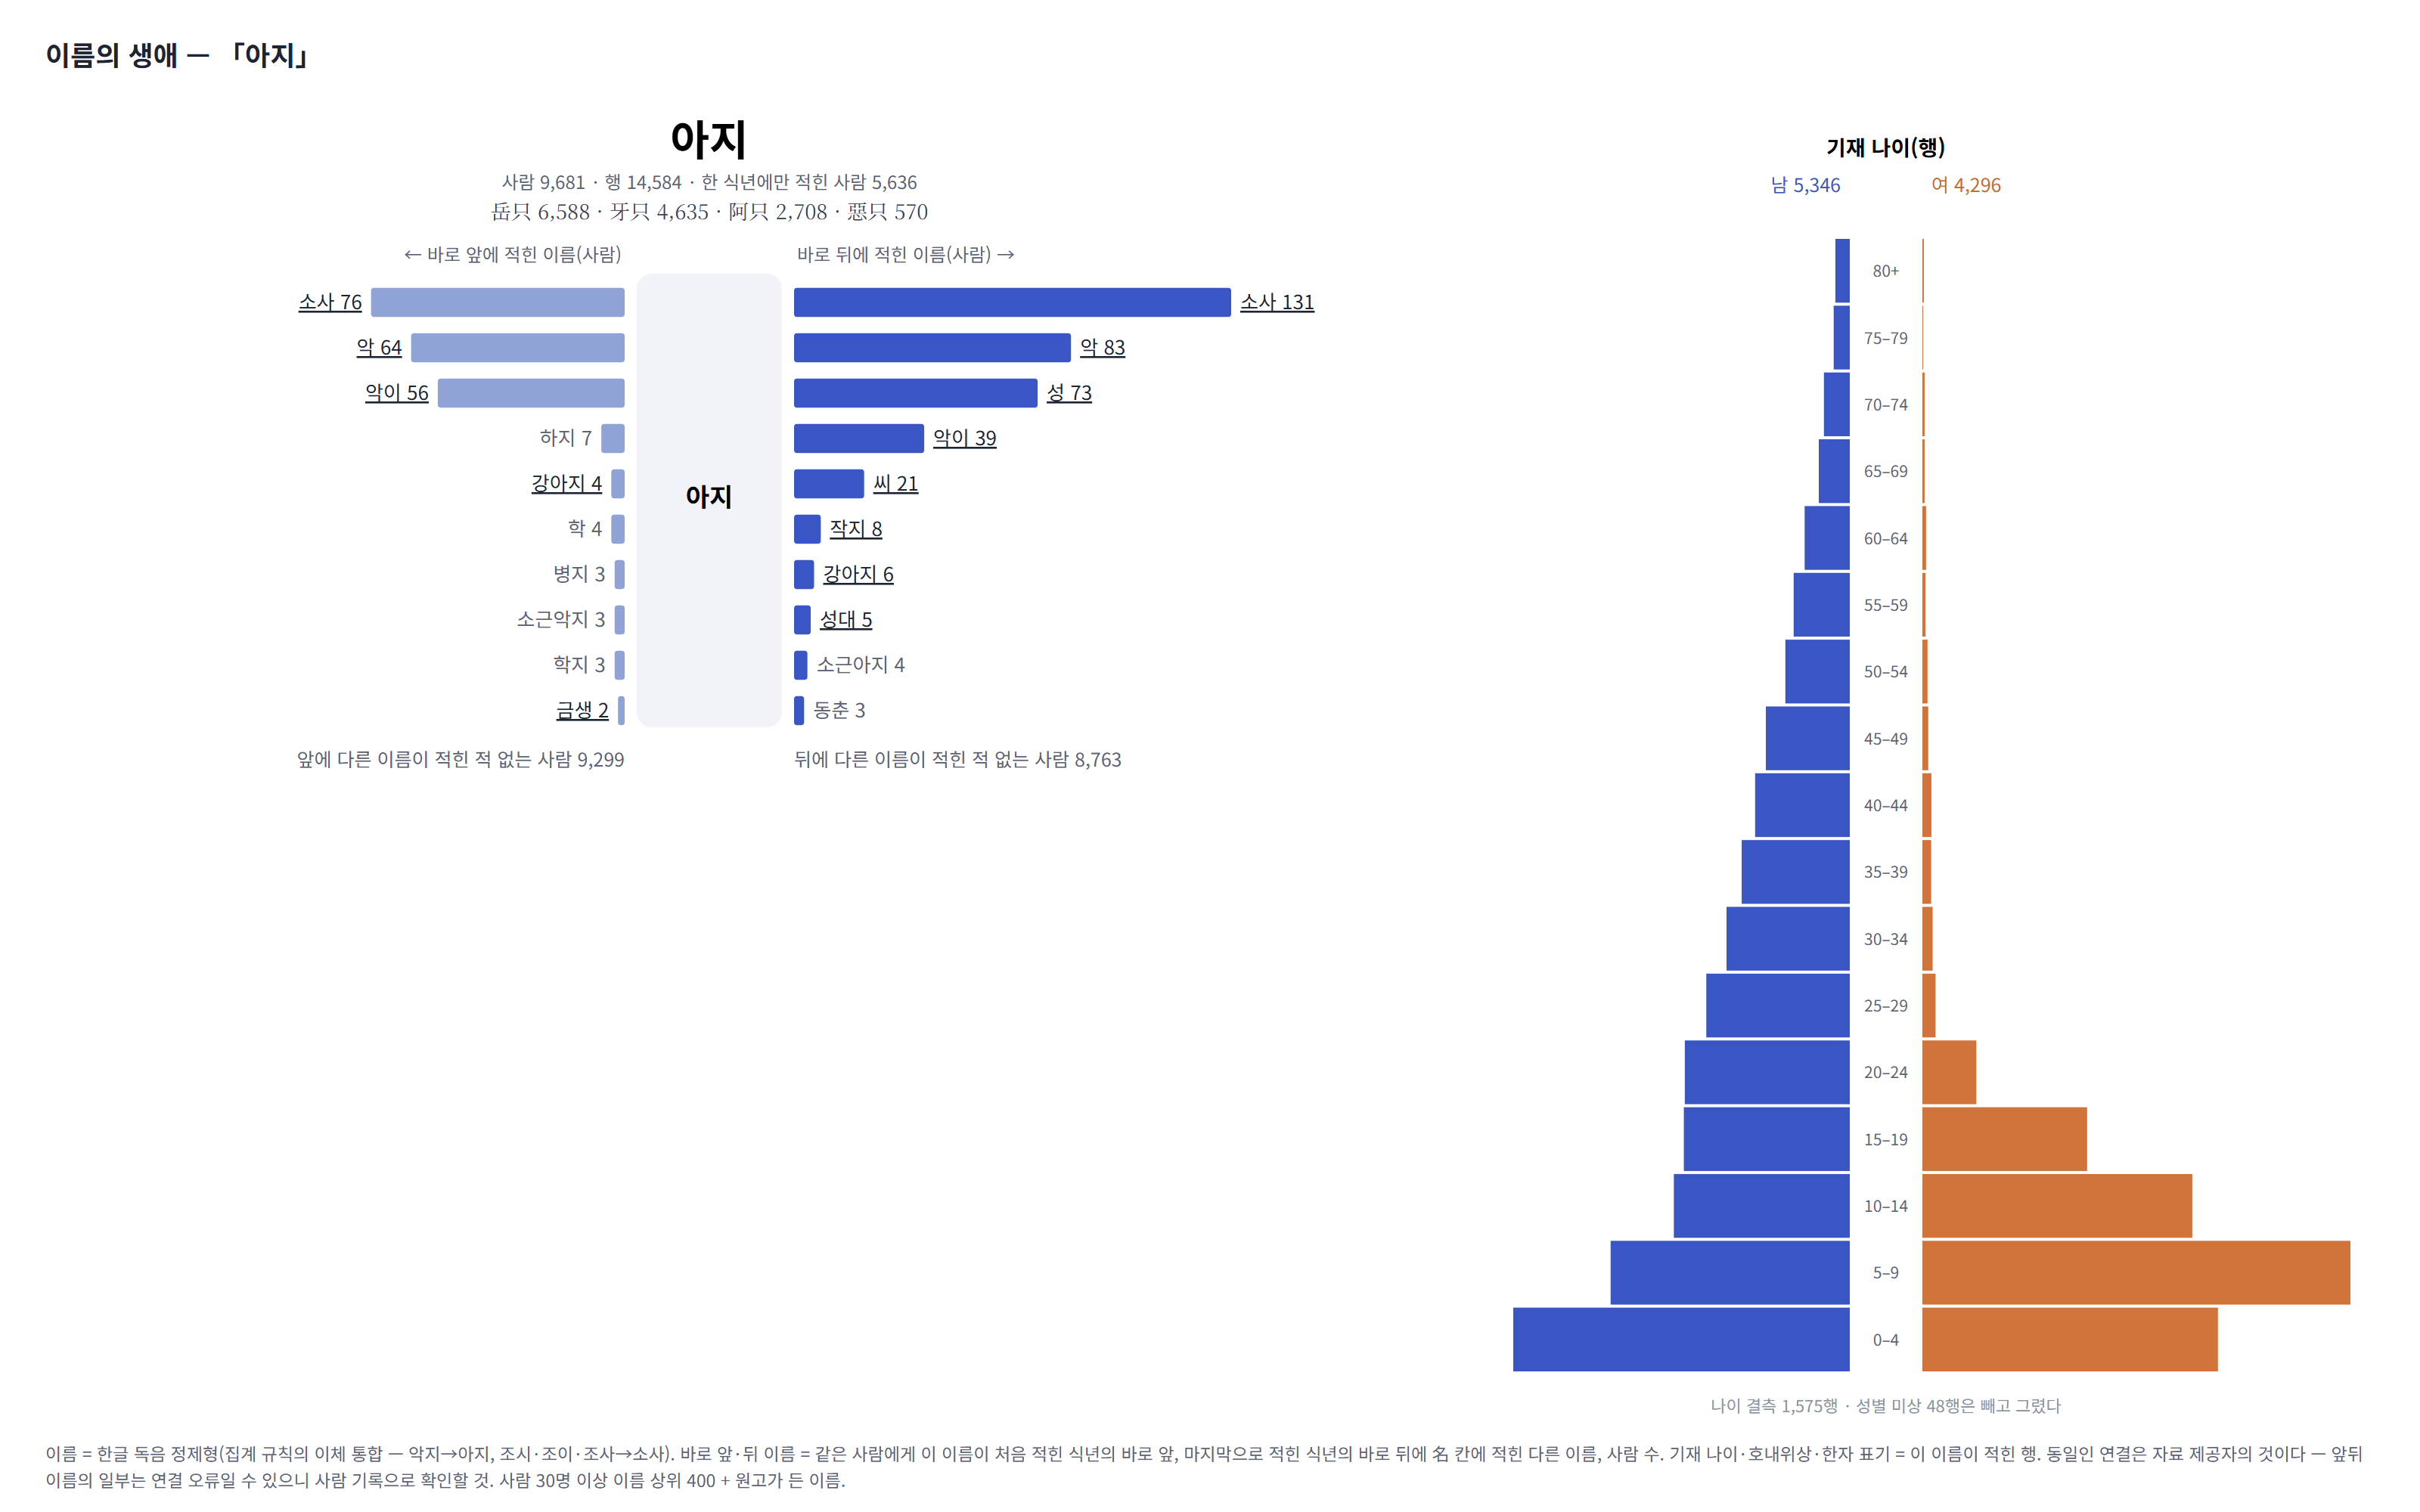
이름의 생애 — 「아지」

(다-1) 이름의 생애 — 「아지」

무엇 왼쪽 = 같은 사람(동일인 연결)에게 「아지」 바로 앞과 바로 뒤에 적힌 다른 이름(사람 수). 오른쪽 = 「아지」가 적힌 행의 기재 나이(남·여).

쓰임 아지가 어떤 나이에 적히고 무엇으로 바뀌는지 본다 — 여성은 대부분 25세 미만에 적히고, 뒤에 적힌 이름 상위는 소사 131 · 악 83 · 성 73 · 악이 39 · 씨 21(사람). 남성은 나이가 넓게 퍼져 있다. 원고가 든 아명·연령 지칭어 가능성을 볼 자리다. 담사리·돌이 등 원고가 든 다른 이름도 인터랙션 페이지에서 고를 수 있다.

주의 동일인 연결 오류가 섞일 수 있다 — 인터랙션 페이지의 사람 기록으로 확인할 것. 이름은 한글 독음 정제형이다(악지는 아지로 묶인다).

(라) 기재 식년과 코호트

원고 Ⅳ장 4절 「실제 기재 관행의 통시적 변화를 확인하기 위해서는 지칭어가 기록된 식년을 기준으로 별도의 집계를 진행할 필요가 있다.」
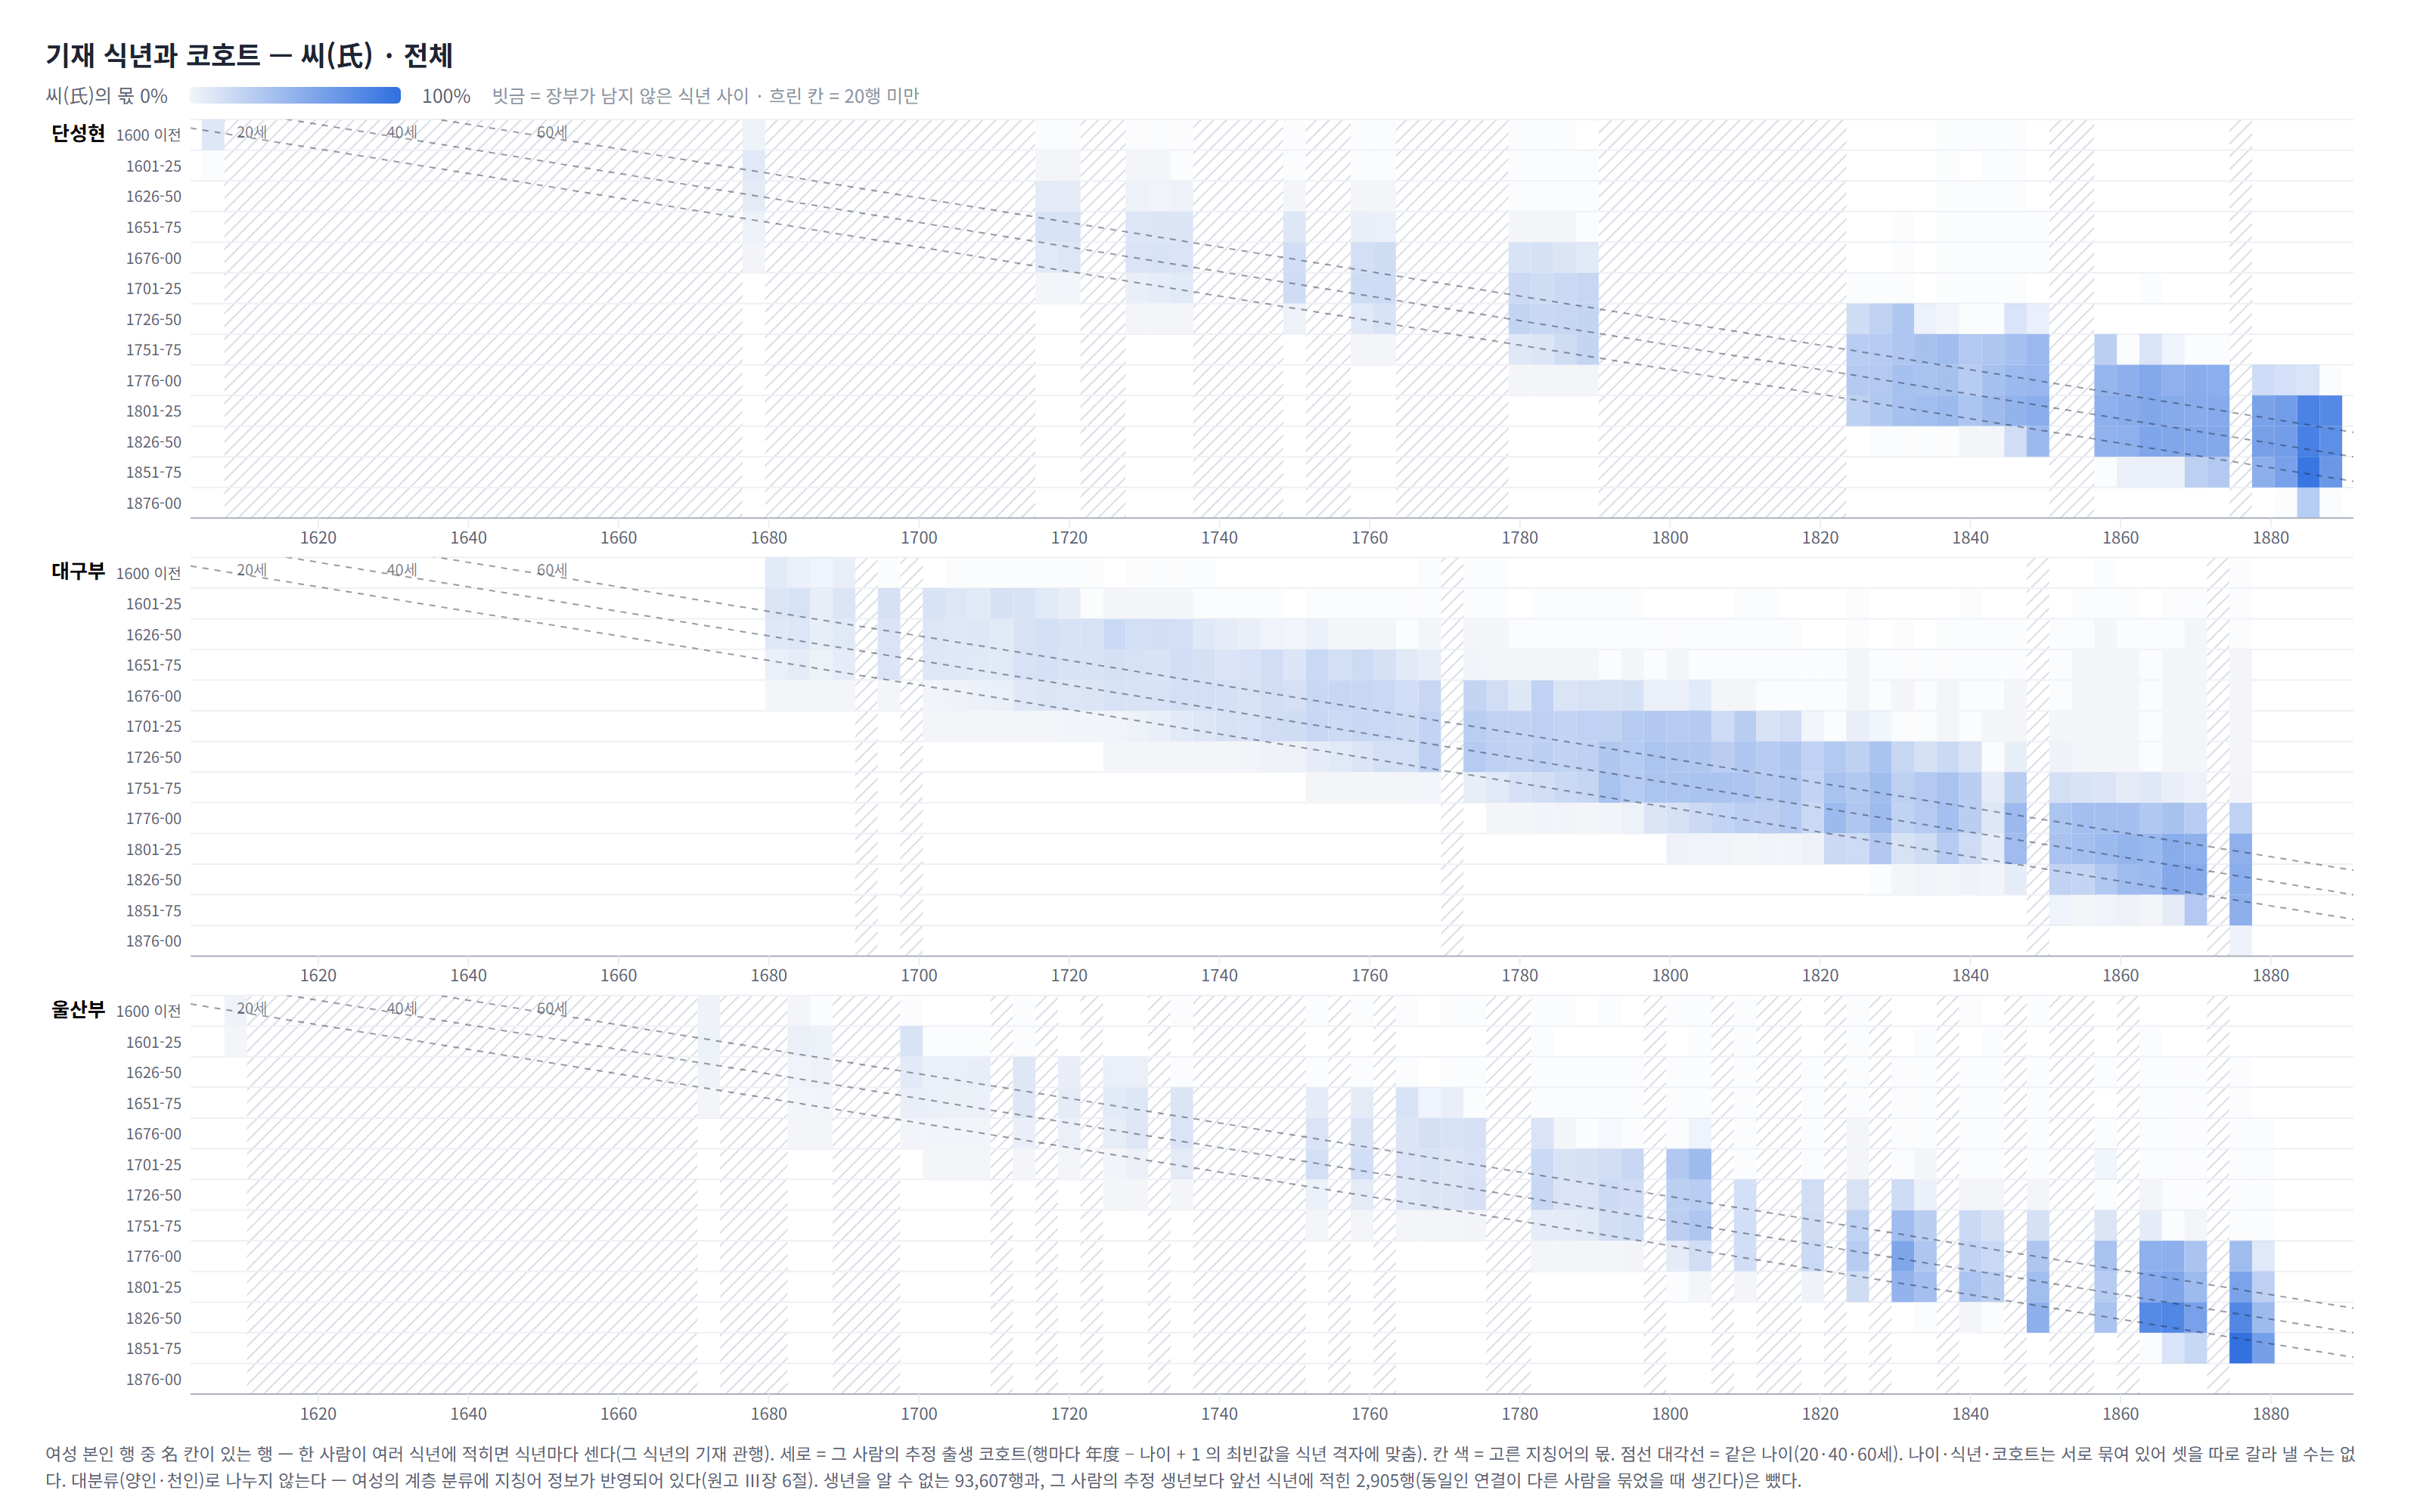
기재 식년과 코호트 — 씨(氏) · 여성 전체

(라-1) 기재 식년과 코호트 — 씨(氏) · 여성 전체

무엇 가로 = 기재 식년, 세로 = 출생 코호트, 칸 색 = 그 식년·코호트의 여성 행에서 氏 의 몫. 빗금 = 장부가 남지 않은 식년 사이, 점선 = 같은 나이(20·40·60세). 지역마다 한 장.

쓰임 氏 의 증가가 세로 띠(어느 식년부터 모든 세대에 — 기재 관행의 변화)인지 가로 띠(어느 세대부터 — 세대의 변화)인지 본다.

주의 행 단위로 센다(한 사람이 여러 식년에 적히면 식년마다). 나이·식년·코호트는 서로 묶여 있어 셋을 따로 갈라 낼 수 없다. 생년을 알 수 없는 행과, 추정 생년보다 앞선 식년에 적힌 2,905행(동일인 연결 오류로 보인다)은 뺐다. 대분류(양인·천인)로는 나누지 않았다 — 여성의 계층 분류에 지칭어 정보가 반영되어 있다(원고 Ⅲ장 6절).

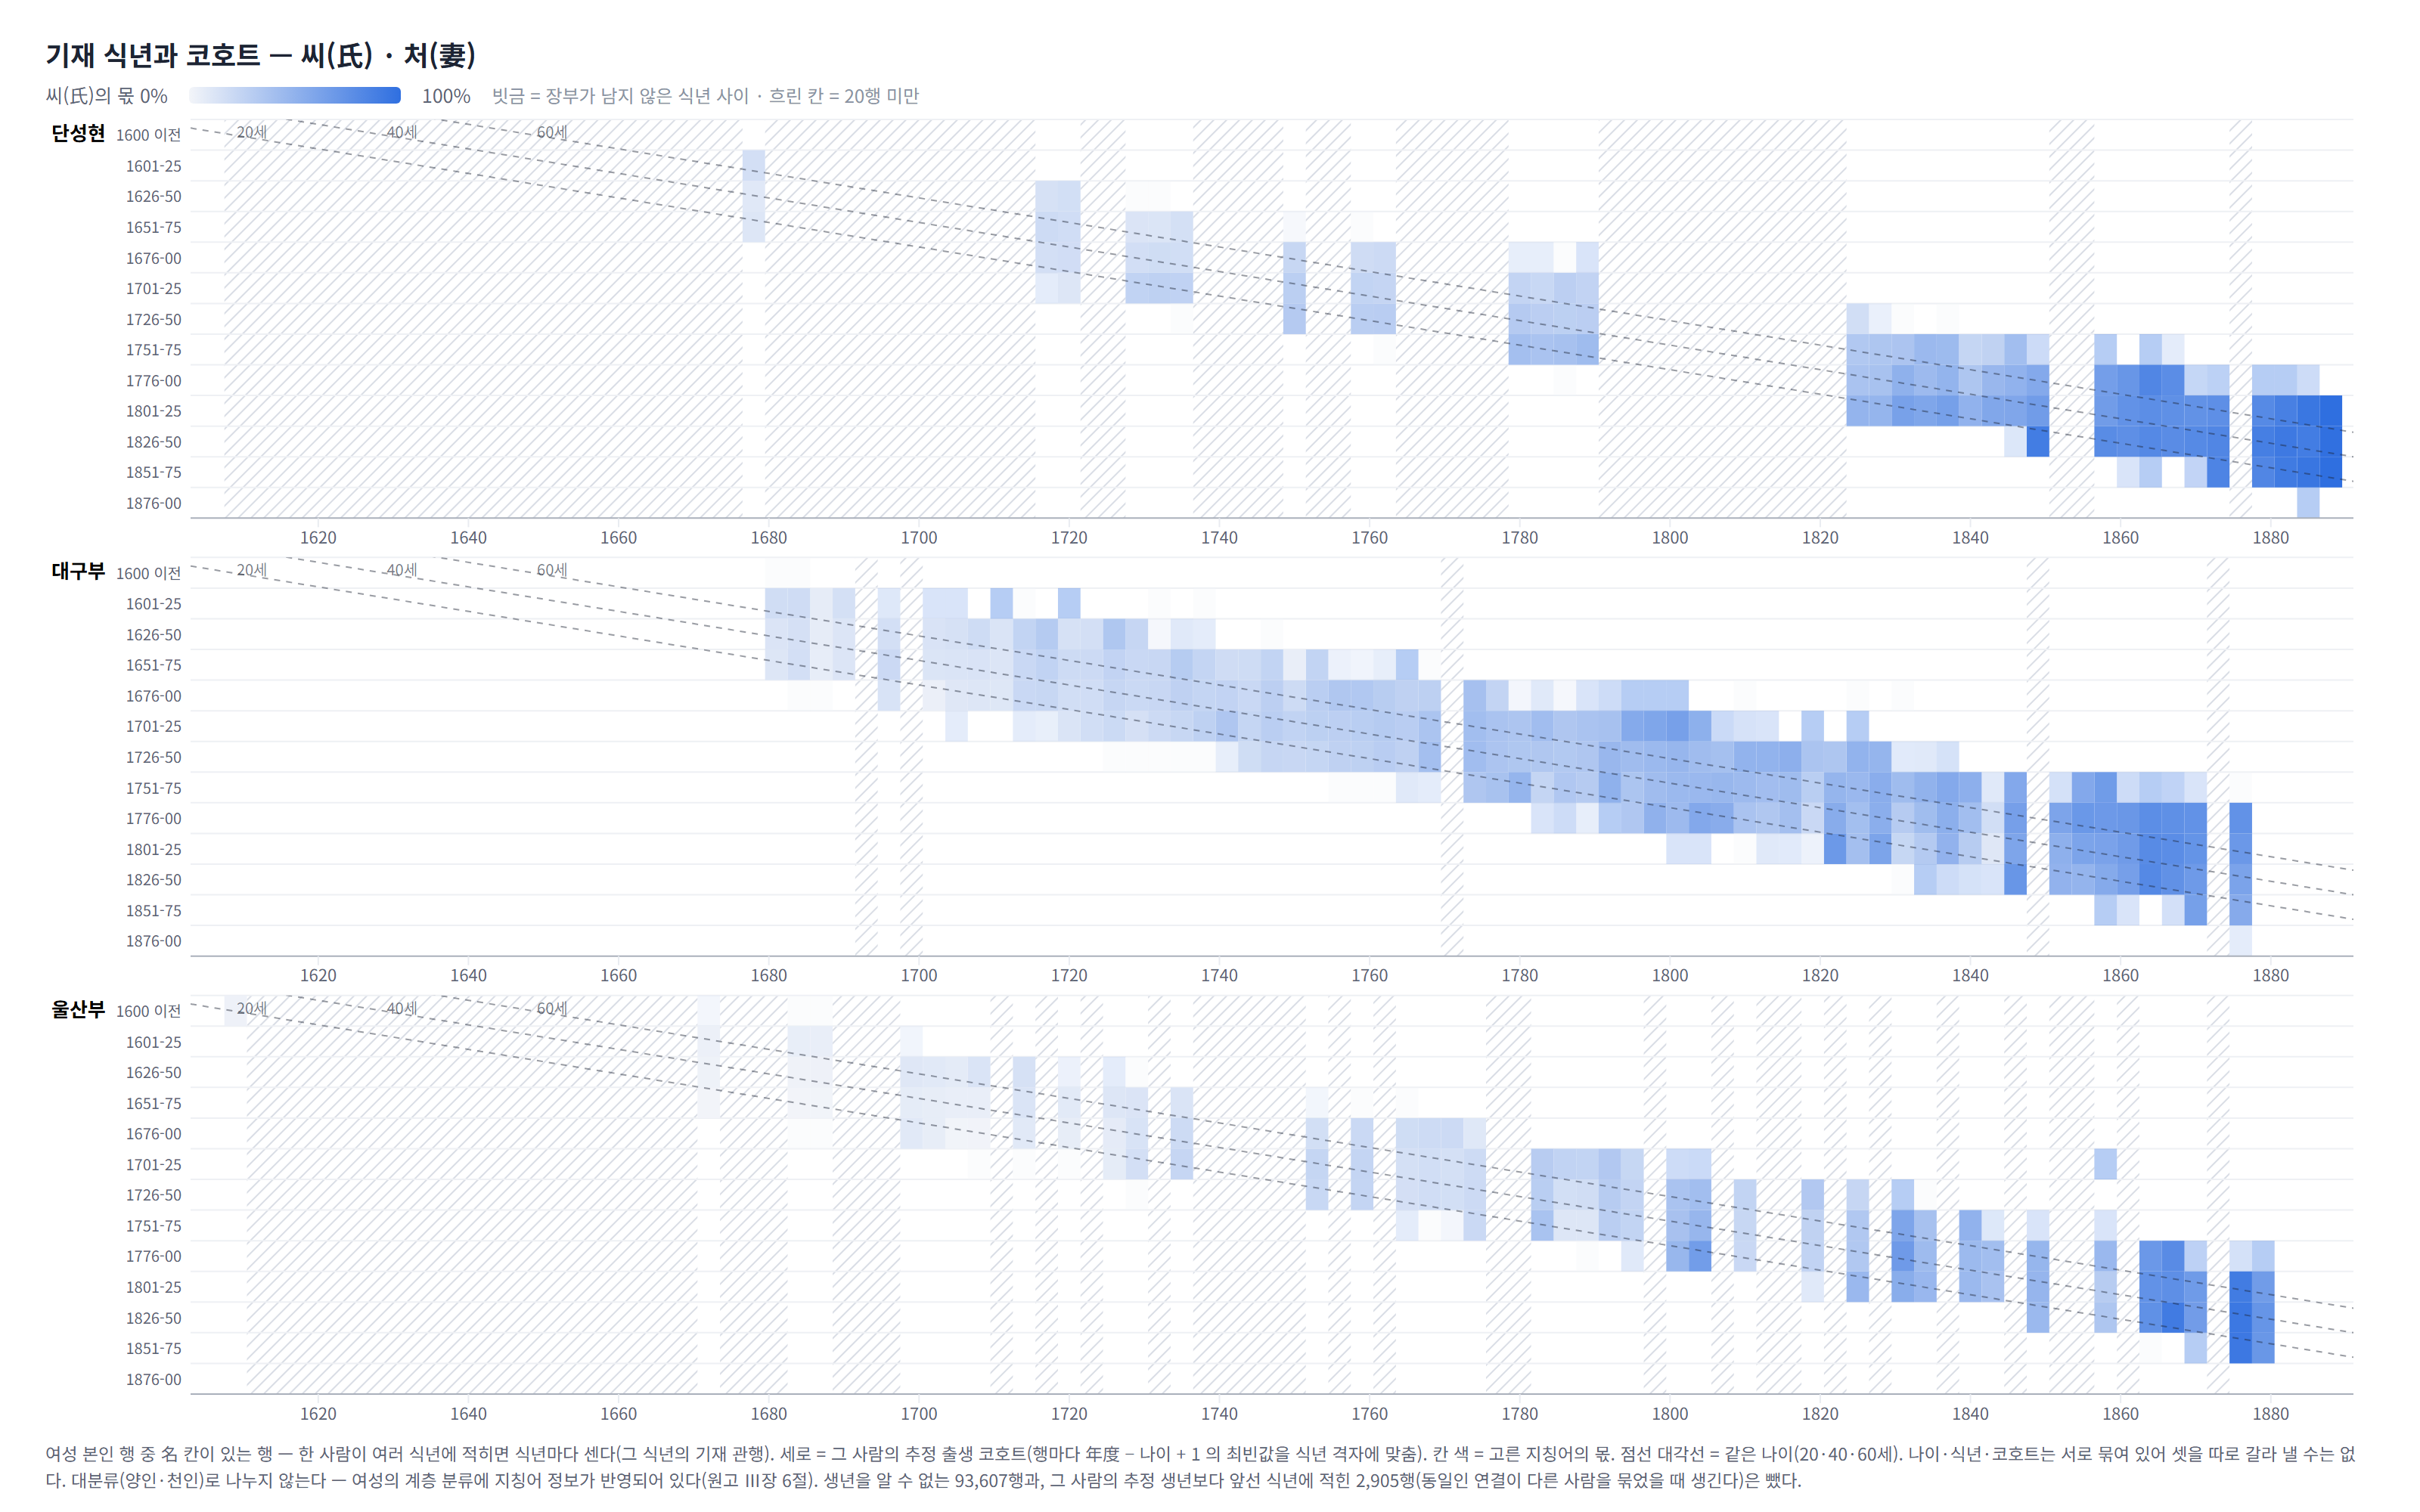
기재 식년과 코호트 — 씨(氏) · 처(妻)

(라-2) 기재 식년과 코호트 — 씨(氏) · 처(妻)

무엇 같은 그림을 호내위상 처(妻)인 행만으로.

쓰임 원고가 「동일한 호내 위상과 혼인 상태에 속하는 여성들을 비교할 필요」라 한 자리 — 처끼리만 보아도 같은 변화가 나타나는지. 인터랙션 페이지에서 며느리(婦)·딸(女·率女)·노비, 그리고 성(姓)·소사형·기타 이름으로 바꿔 볼 수 있다.

주의 위와 같다.

(마) 목록 길이

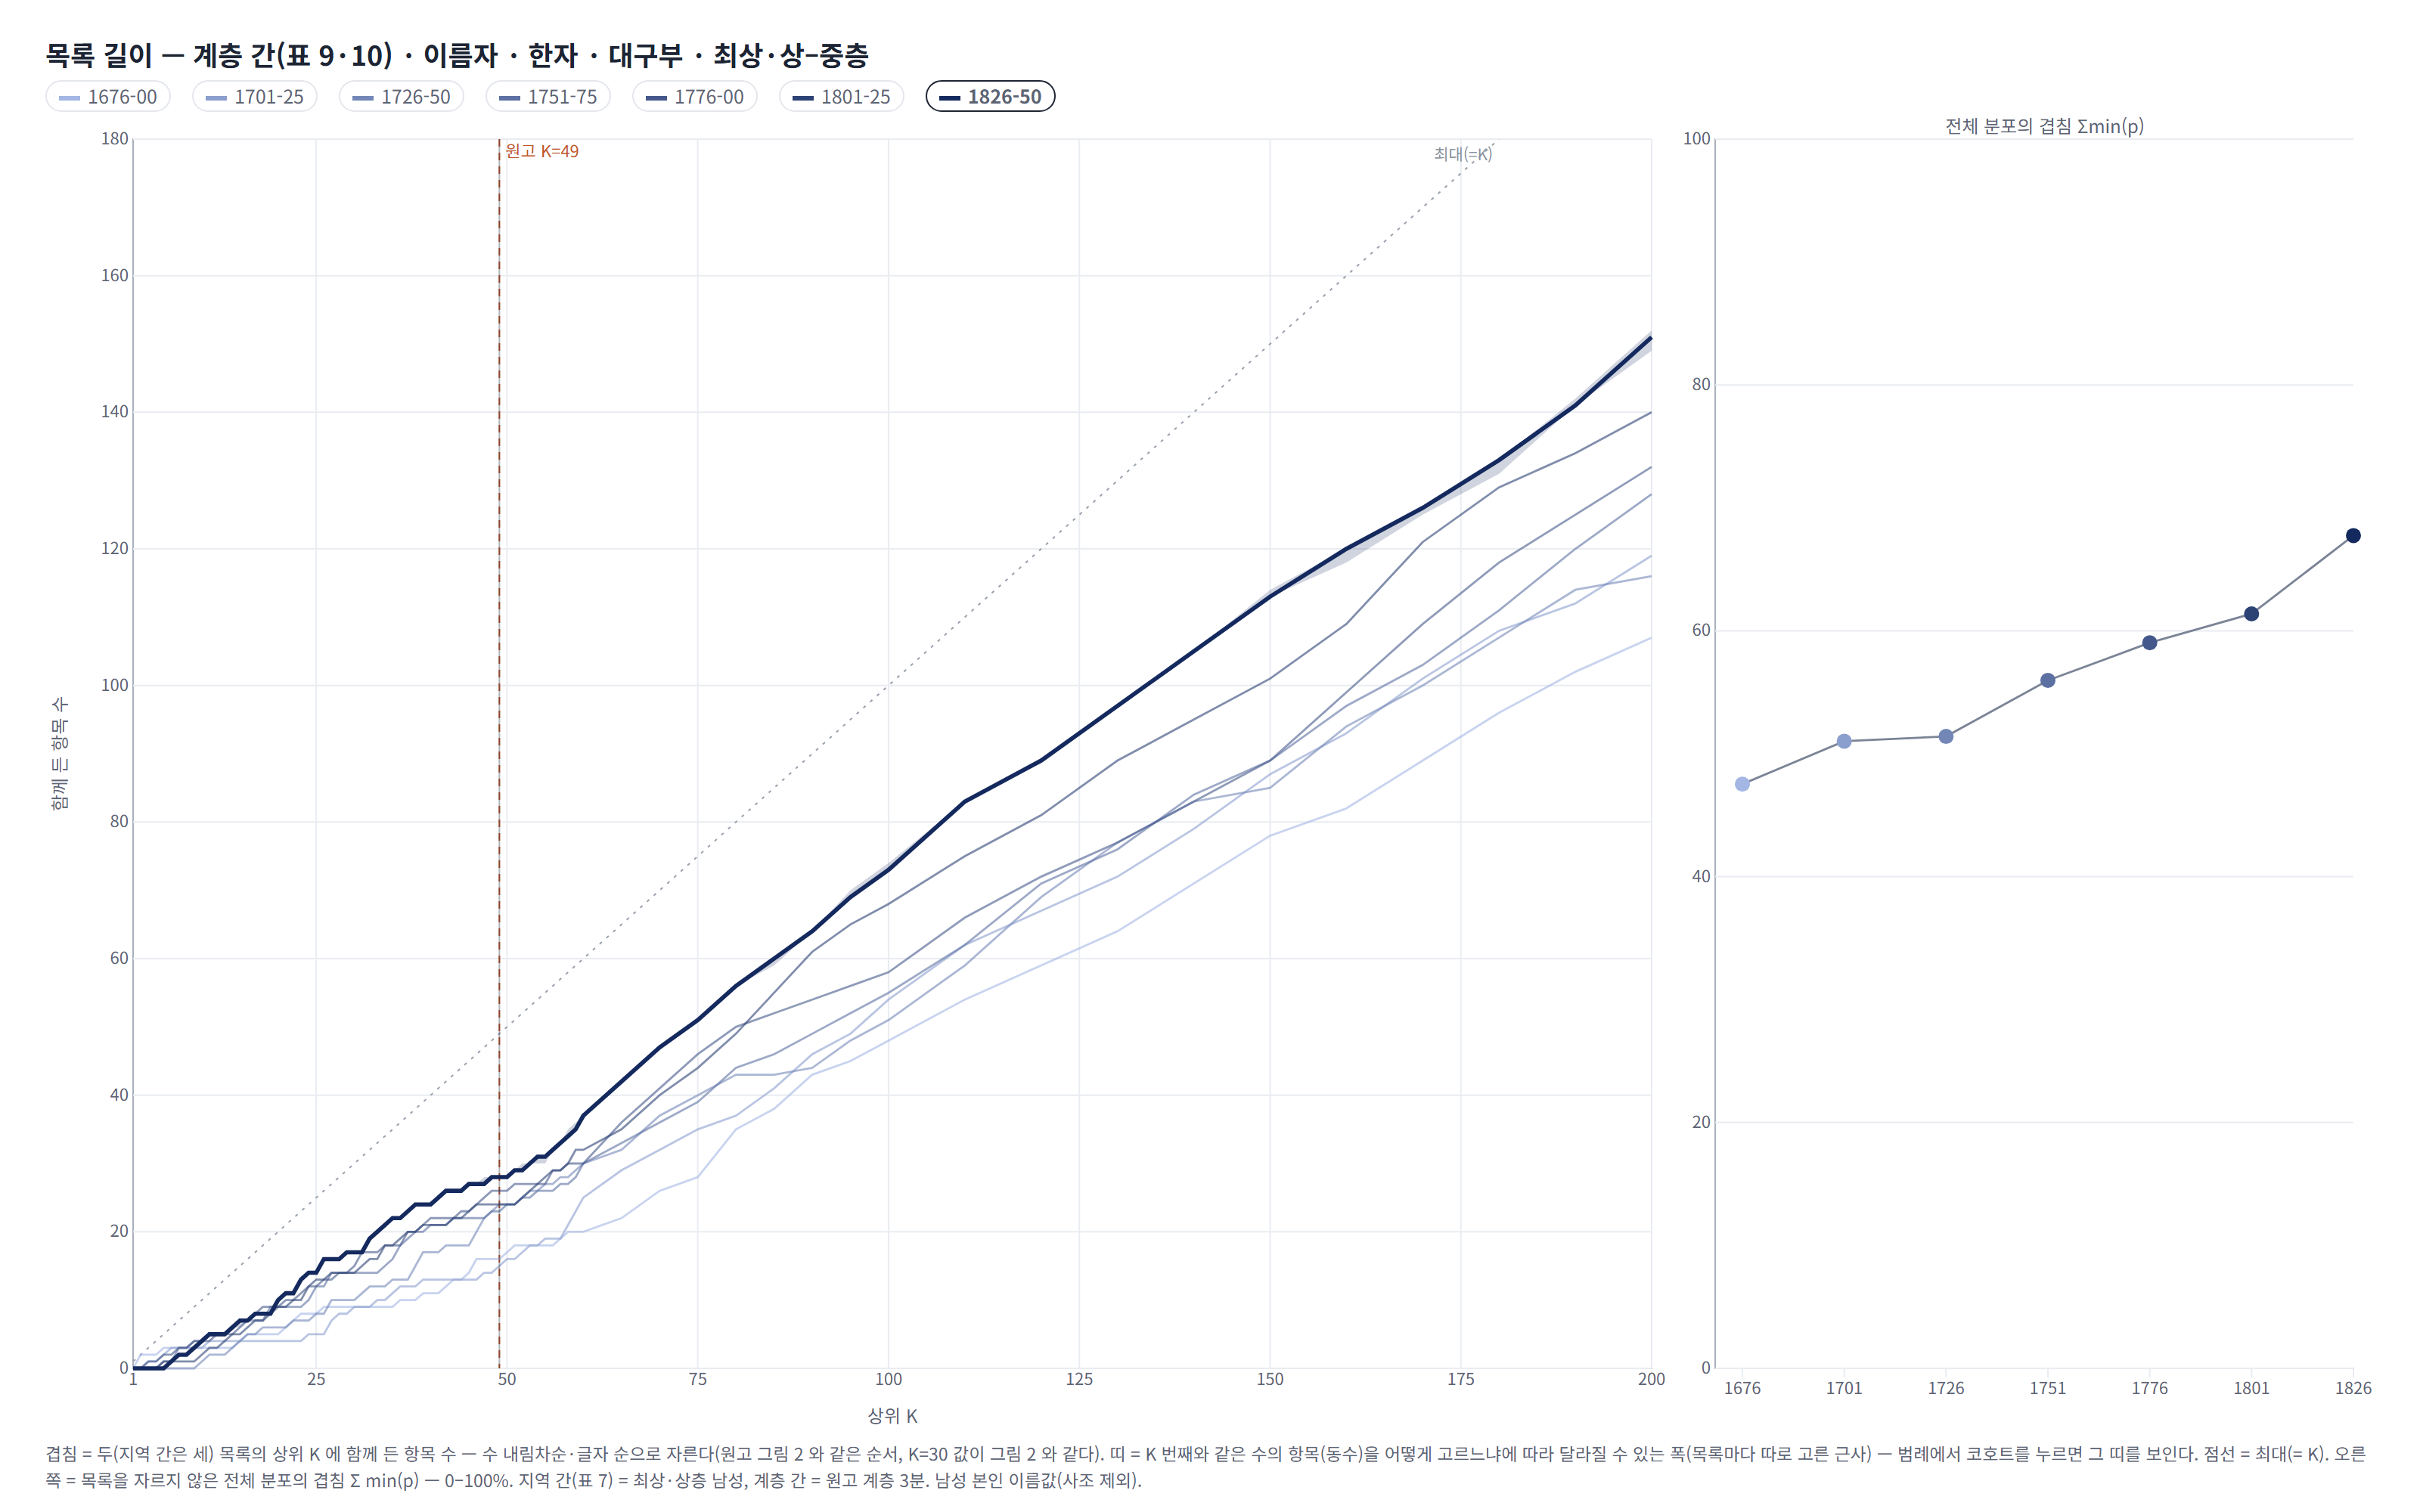
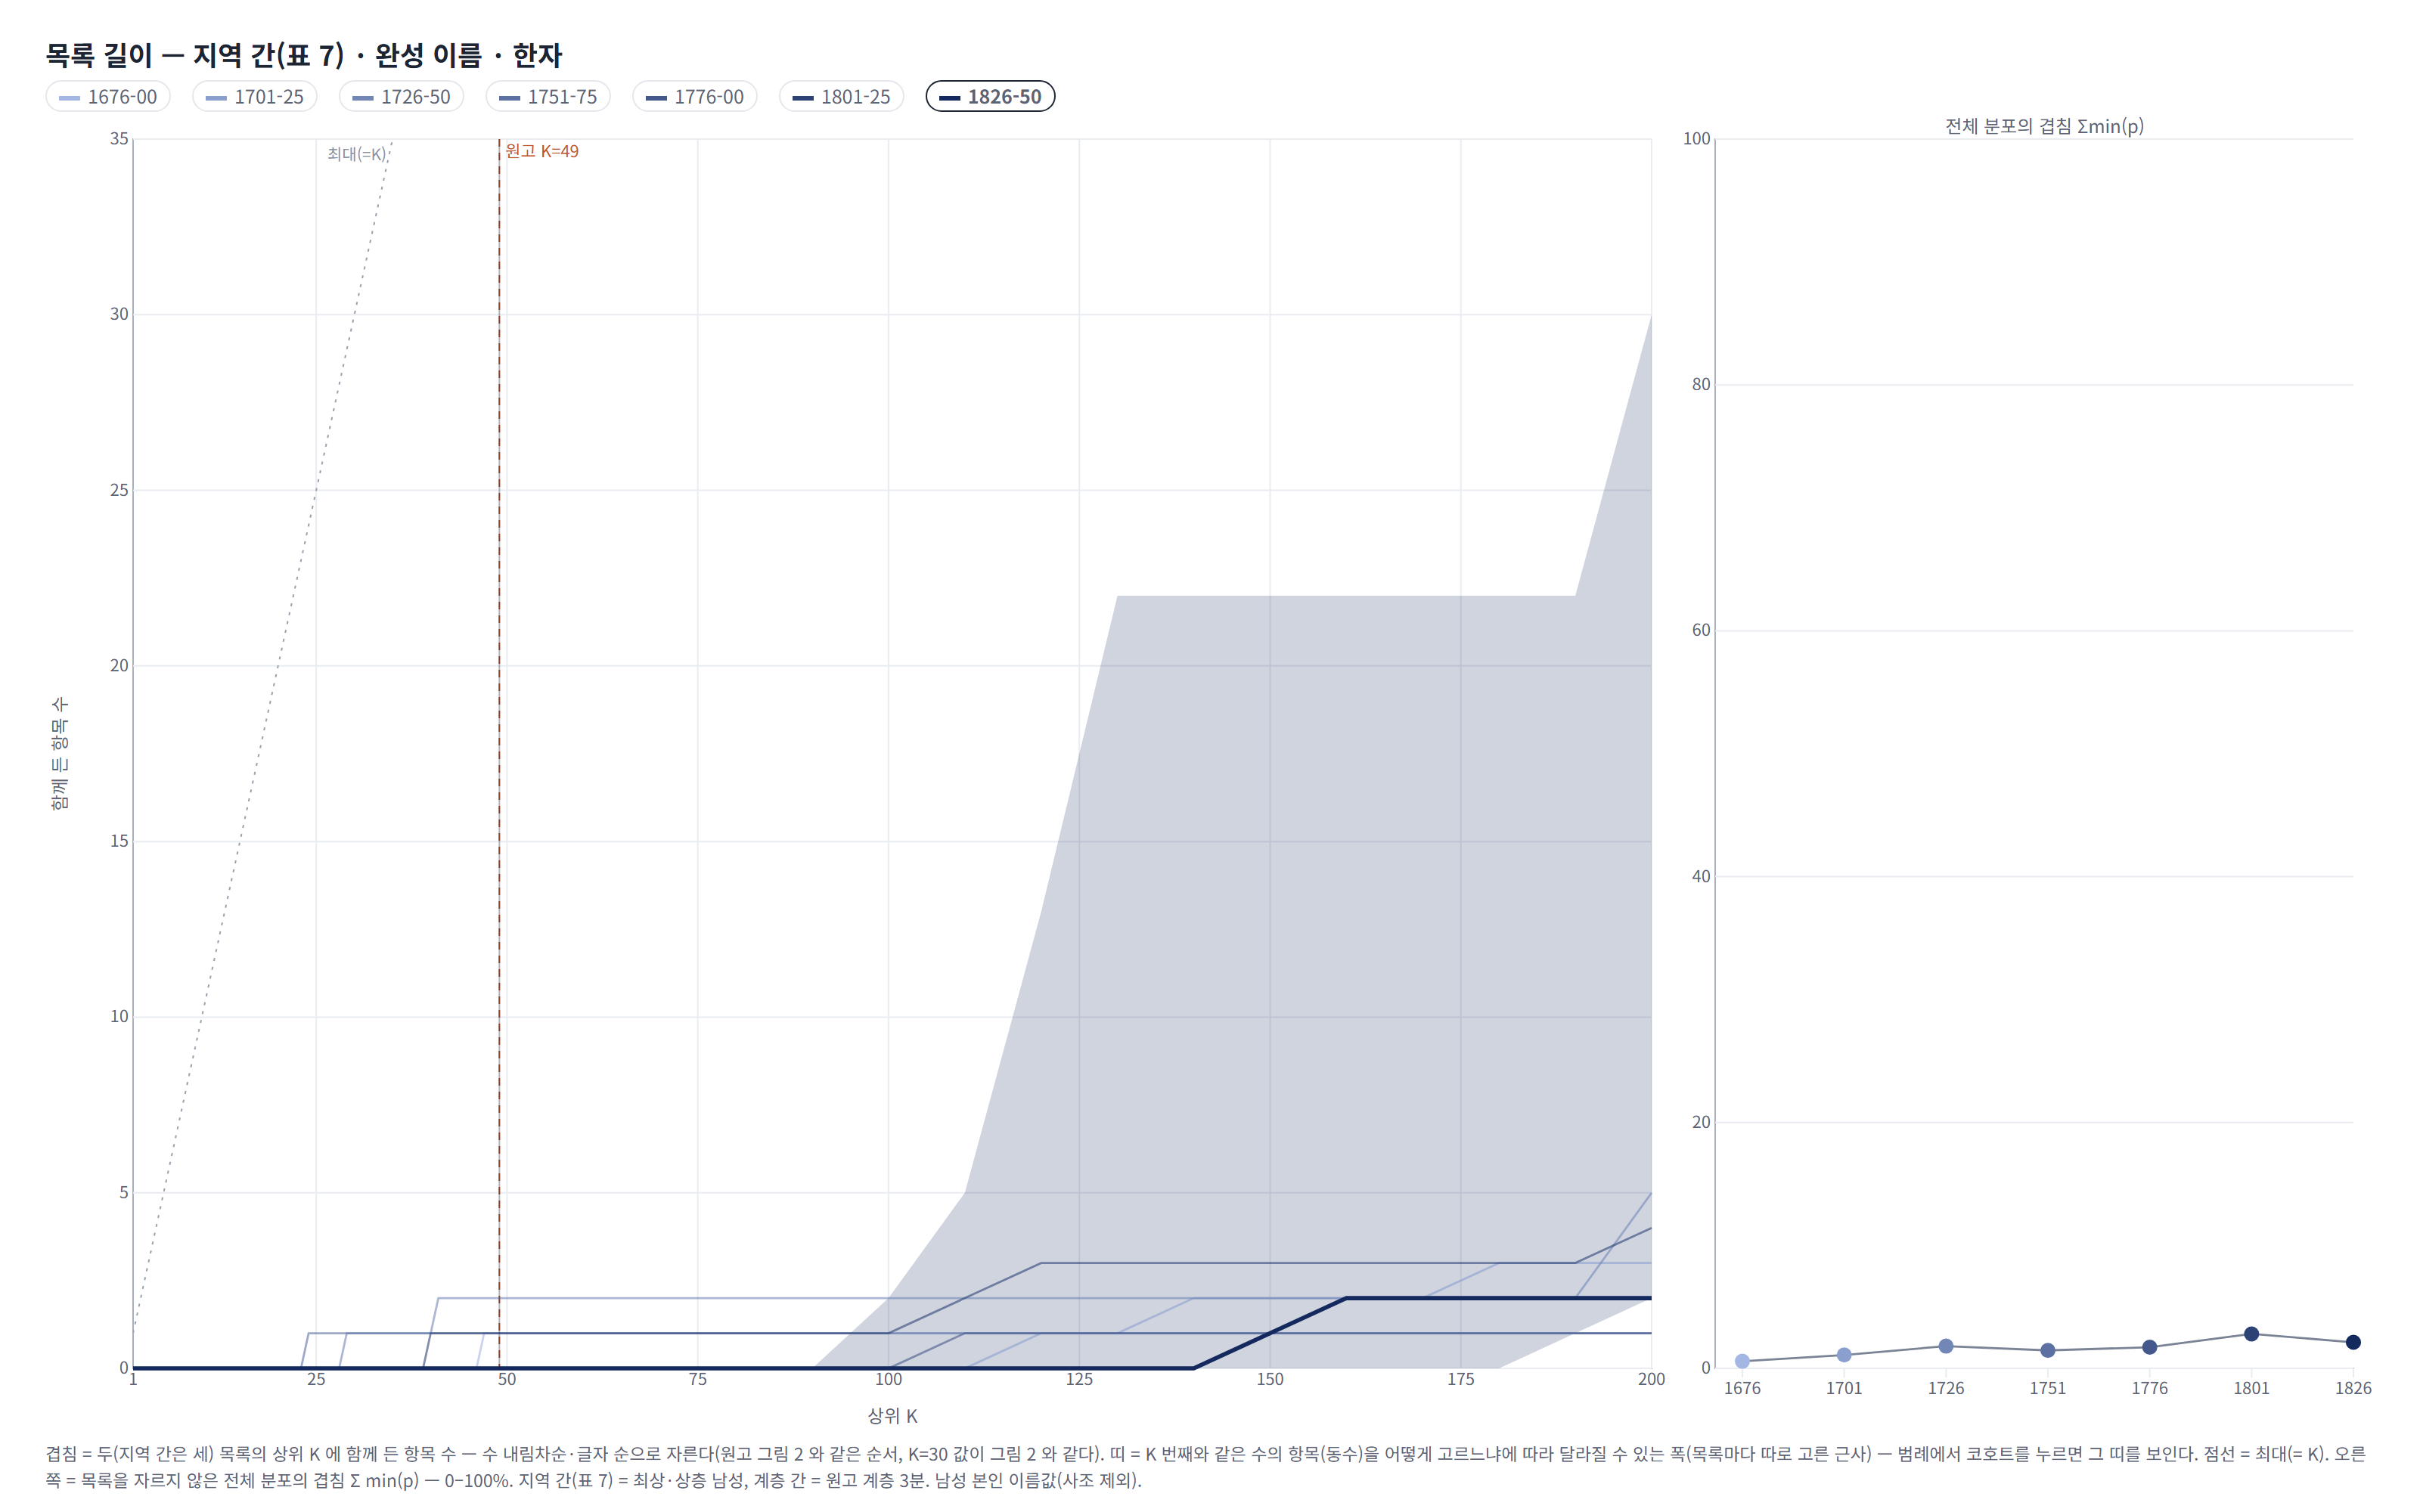
원고 Ⅳ장 1·3절 「상위권 목록의 중첩이 전체 이름자 분포의 유사성을 직접 측정하는 것은 아니기 때문이다.」

원고 표 7·9·10 은 상위 49·30 목록의 겹침이다. 목록 길이 K 를 1–200 으로 움직여 결론이 그 K 에서만 성립하는지 보고, 목록을 자르지 않은 전체 분포의 겹침을 함께 보인다.

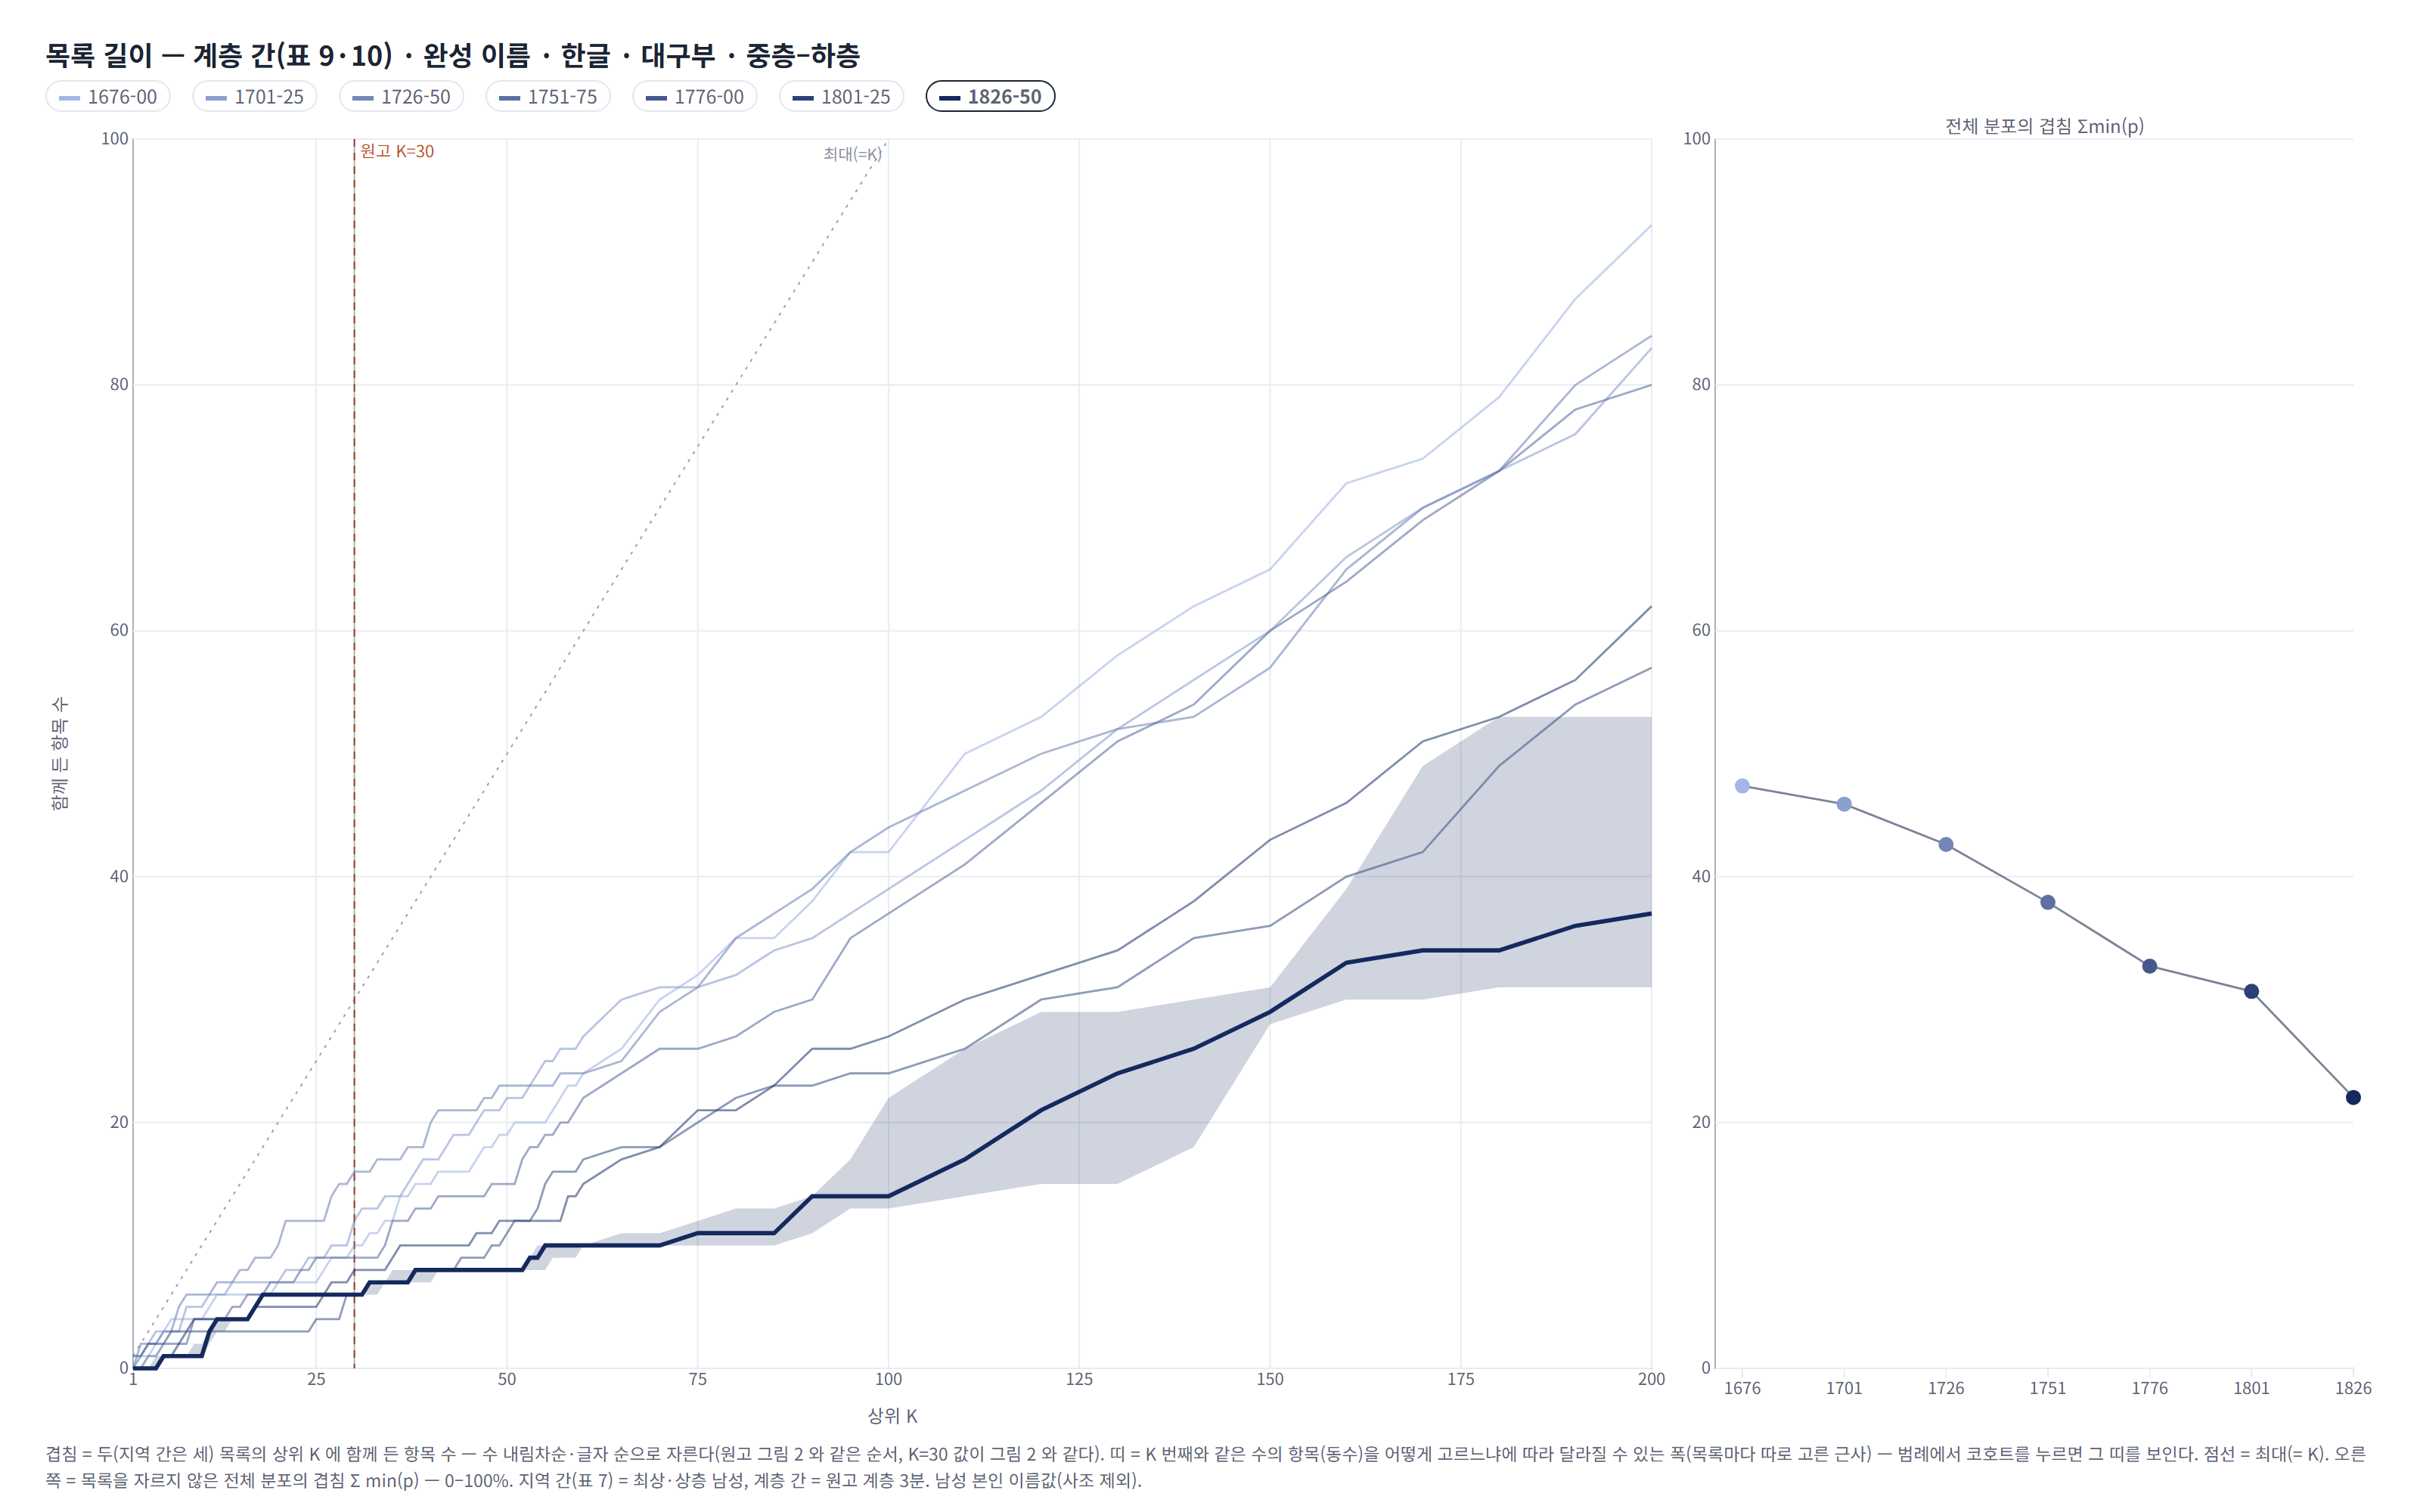
목록 길이 — 표 10 꼴 · 대구부 중층–하층 · 한글 완성 이름

(마-1) 목록 길이 — 표 10 꼴 · 대구부 중층–하층 · 한글 완성 이름

무엇 가로 = 상위 K, 세로 = 두 계층의 상위 K 에 함께 든 완성 이름 수, 코호트마다 선(옅을수록 이른 코호트). 붉은 점선 = 원고의 K(30). 띠 = K 번째와 같은 수의 이름(동수)을 어떻게 고르느냐에 따른 폭(1826–1850). 오른쪽 = 전체 분포의 겹침 Σmin(p).

쓰임 원고 표 10 의 결론이 K=30 에서만 성립하는지 본다 — 대구부 중층–하층의 전체 분포 겹침은 1676–1700 47.4% 에서 1826–1850 22.0% 로 줄어, 원고 Ⅳ장 3절이 적은 19세기 전반의 공유 약화와 같은 방향이다.

주의 띠(동수 폭)는 목록마다 따로 고른 근사다.

목록 길이 — 표 9 꼴 · 대구부 최상·상층–중층 · 한자 이름자

(마-2) 목록 길이 — 표 9 꼴 · 대구부 최상·상층–중층 · 한자 이름자

무엇 같은 문법으로 이름자. 붉은 점선 = 원고의 K(49).

쓰임 원고 표 9(상위 49 이름자의 공통 수)가 보인 두 계층의 공통성 확대가 K 를 바꿔도 유지되는지, 전체 분포의 겹침에서도 그런지 본다.

주의 인터랙션 페이지에서 지역·계층 쌍을 바꿔 볼 수 있다.

목록 길이 — 표 7 꼴 · 세 지역 · 최상·상층 · 한자 완성 이름

(마-3) 목록 길이 — 표 7 꼴 · 세 지역 · 최상·상층 · 한자 완성 이름

무엇 세 지역 상위 K 완성 이름의 교집합 수. 붉은 점선 = 원고의 K(49).

쓰임 원고 표 7 의 「공통 완성 이름은 극히 적다」가 K 를 늘려도 그런지 본다. 이름자(단위)로 바꾸면 표 7 의 오른쪽 열(공통 이름자)과 같은 꼴이다.

주의 세 목록을 함께 자르므로 두 목록일 때보다 동수 폭이 크게 나올 수 있다.